从试点到生产:7 个企业真实难题与解法
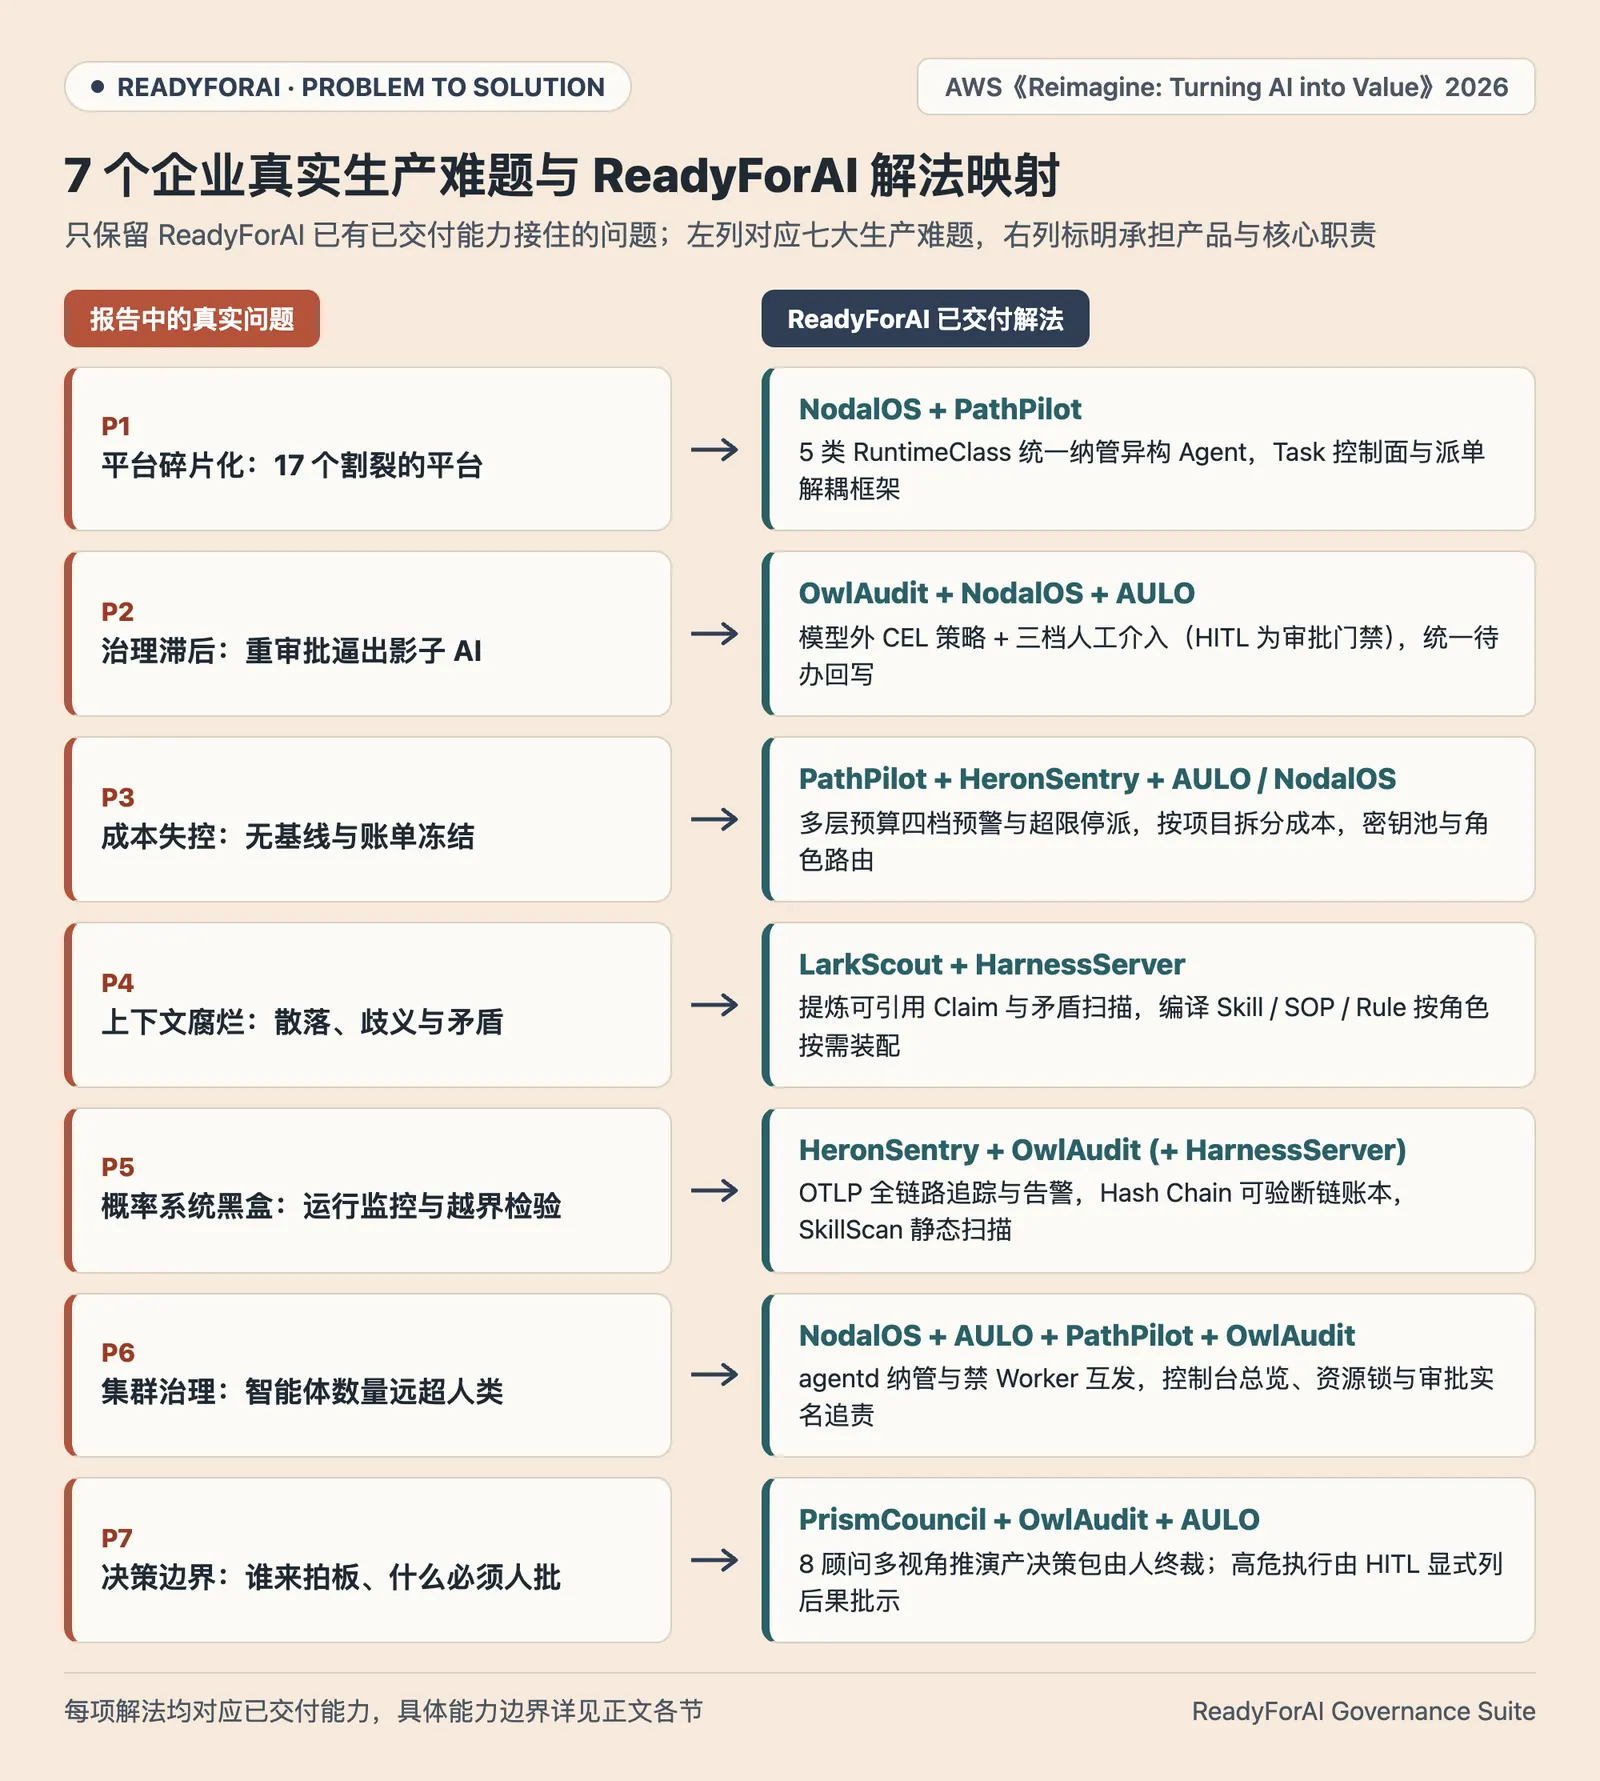
对照 AWS 驻场高管团队 2026 年《Reimagine: Turning AI into Value》报告,拆解企业把智能体 AI 从试点推向生产时遇到的七个真实难题:平台碎片化、治理滞后、成本失控、组织上下文腐烂、概率系统可观测、集群治理与决策边界,并逐一给出 ReadyForAI 已交付产品的解法与边界。
本文目录(9)
2026 年,AWS 驻场高管团队(Executives in Residence)发布了《Reimagine: Turning AI into Value》报告。团队历时 9 个月、跨越四大洲 23 个行业,访谈了来自 128 家组织的 154 位高管(以及 30 多位亚马逊内部业务负责人,并结合覆盖 27 个国家、3.5 万多名从业者的内部研究),试图回答一个问题:为什么多数企业还停留在试点阶段,只有少数组织把 AI 真正变成了业务价值?
报告引用的数据显示出一个明显的落差:84% 的高管相信智能体 AI(Agentic AI)将重塑业务,但目前只有 6% 敢把它放进核心流程;近 79% 的组织计划来年继续加码智能体 AI 投入(出自报告引用的 AWS 博客 Agentic AI: Bridging the Widening Gap Between Ambition and Execution)。与此同时,Gartner 预测到 2027 年底,超过 40% 的智能体 AI 项目会被取消,原因不是模型不够聪明,而是成本失控、治理不足、价值不清。
报告在开篇给出了总判断:真正从 AI 中获得最多价值的组织,不是部署 AI 最多的组织,而是清楚 AI 该做什么、同样也清楚它不该做什么的组织。
本文不做泛泛的报告摘编,而是用「问题 → 解法 → 边界」的工程视角,从报告里挑出企业把智能体从试点推向生产时典型的 7 个真实难题,逐一对照 ReadyForAI 已经交付的能力,讲清楚我们用哪个产品、用什么具体机制去解,以及在什么地方止步。
一、平台碎片化:17 个割裂的平台
问题
报告第 8 章记录了一个很有代表性的现实困境。Advocate Health 副总裁 Meghan Glabach 发现,团队每做一个新 AI 原型就会顺手搭一套自己的技术底座;不到两年,她清点出了 17 个互不相连的平台——每一个都小到管不住,相互之间又差异大到合不拢。
另一头的错误同样危险:脱离真实业务用例,试图从零造一个“能覆盖所有未来场景”的大一统超级平台。这种平台在落地前就变得复杂僵化,业务团队想接新数据源或改编排逻辑,都必须排长队等中心团队审批和代为部署,结果把平台做成了全公司的研发瓶颈。
报告给出的判断很清醒:平台团队应该做“赋能者,而非守门人”(an enabler, not a gatekeeper);在编排层应当坚持 “买通用基础设施、自己掌握编排逻辑”(Buy the infrastructure and own the logic)——因为上层框架变化很快,不绑定单一框架才能保住企业自己的业务流程资产。
我们的解法
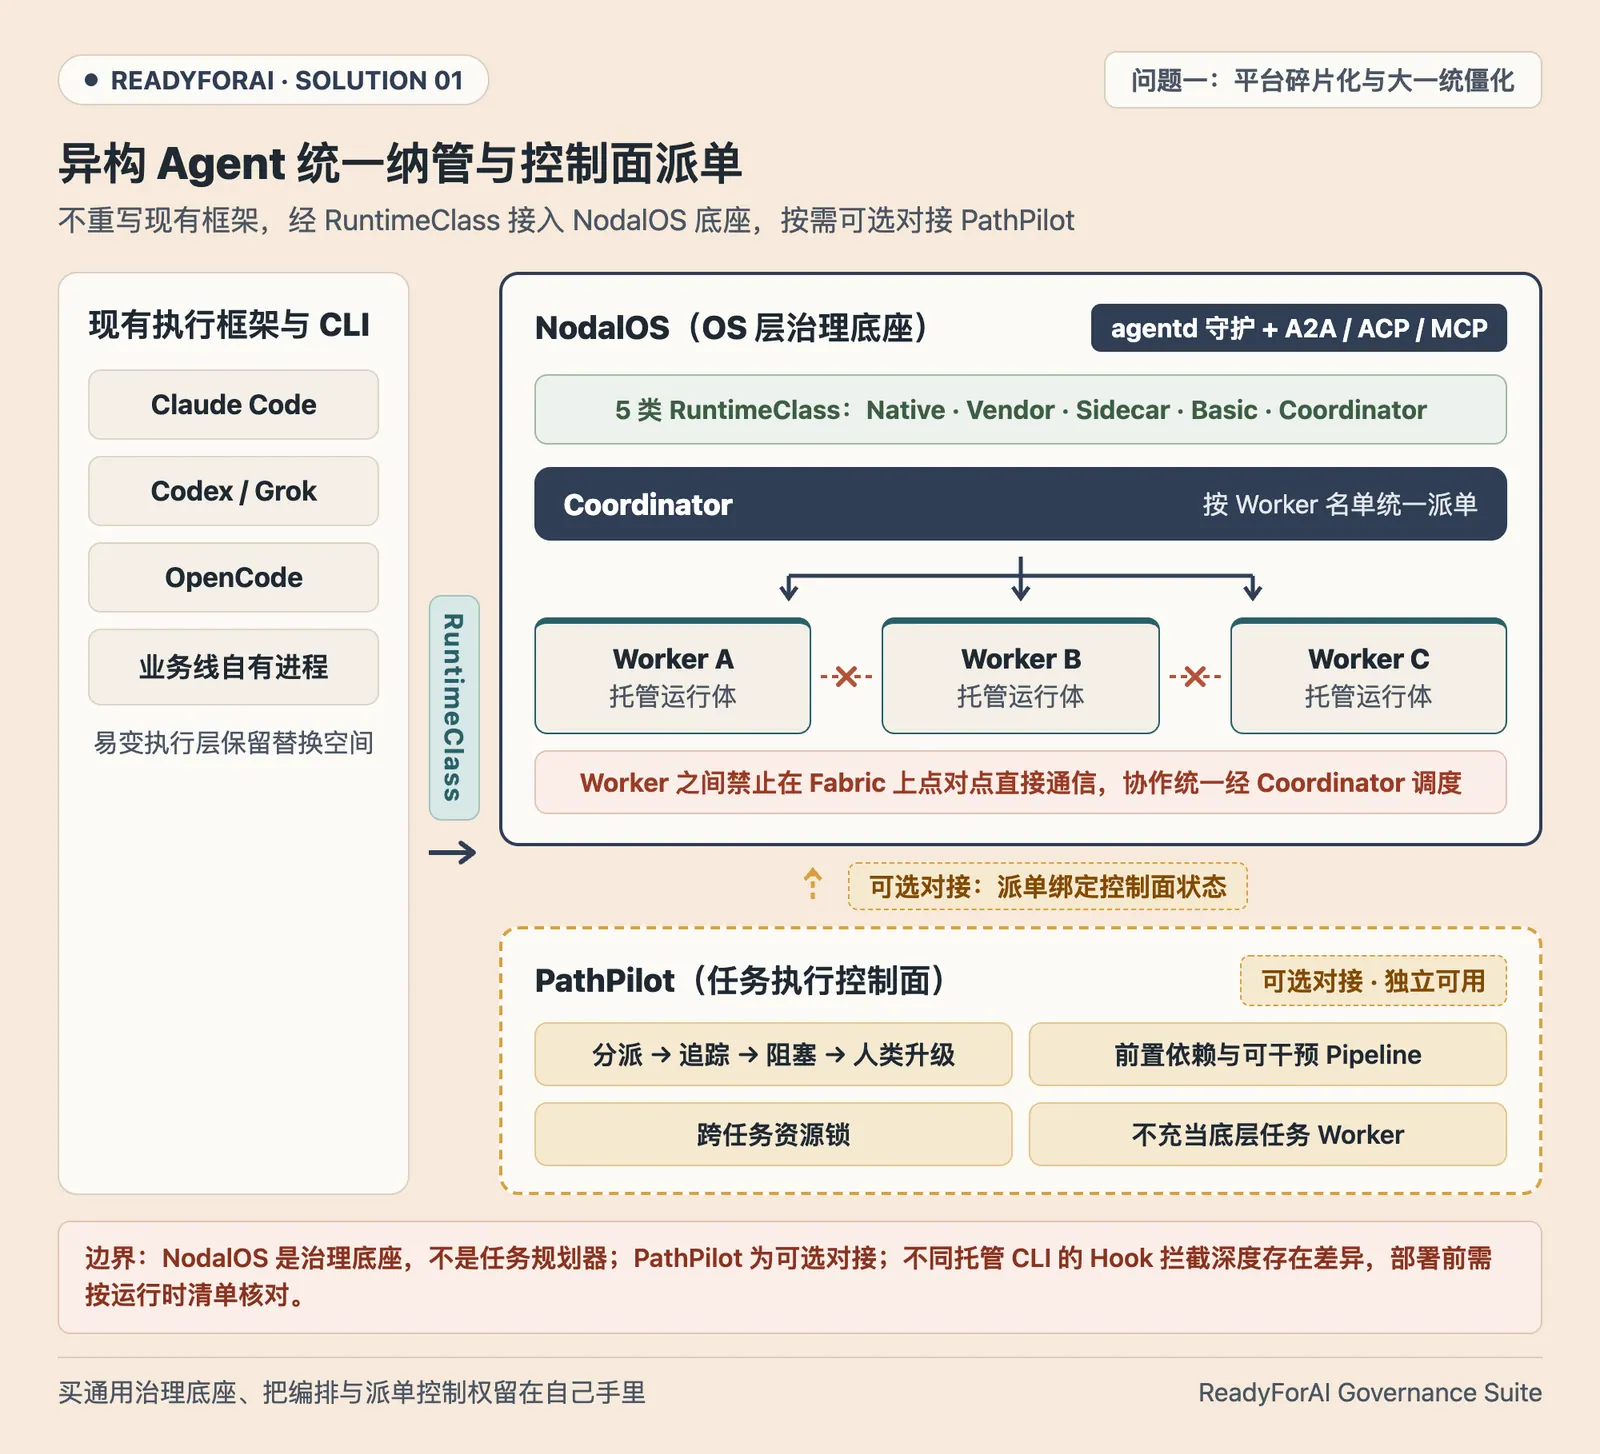
延续我们在控制面必须自己养和告别“编排剧场”中的架构思路,我们用 NodalOS(架构见 nodalos.org)与 PathPilot 把易变的框架留在执行层,把控制权留在底座与控制面手里。NodalOS 作为治理底座,通过 agentd 守护进程、5 类 RuntimeClass 与原生协议互通纳管既有编码助手或自有进程,并禁止 Worker 之间点对点直接通信,统一经 Coordinator 派单;可选对接 PathPilot 后,派单还能绑定任务闭环、前置依赖、人工升级与跨任务资源锁。这样团队不用重写既有 Agent,就能把分散的运行体收归统一底座调度,且上层框架可随时替换。
边界
NodalOS 是运行时宿主与治理底座,不是任务规划器;PathPilot 为可选对接且不充当底层任务 Worker。此外,不同托管 CLI 工具的 Hook 拦截深度存在差异(例如部分工具没有「询问人」这一步、云侧内置工具不经本地 Hook),部署前需按具体运行时核对支持范围。
二、治理滞后:重审批逼出影子 AI
问题
报告第 5 章引用了 AWS 委托 Strand Partners 在 2025 年开展的欧洲调研(Unlocking Europe's AI Potential):超过半数中小企业、大企业以及四分之三的初创公司已经用上了 AI,但其中仅有 24% 拥有负责任 AI 的书面规范,仅有 10% 具备数据治理战略;而对监管义务感到不确定的企业,计划在来年削减至多 28% 的 AI 投资。
更棘手的冲突发生在审批速度上。企业习惯用管理半年期 IT 项目的委员会、法务评审单和逐项人工把关,去管几天就能搭出的 AI 原型。这种外挂式(bolted-on)治理把所有用例一律当成高风险来审,结果就是逼着一线团队绕开制度——据报告,Boston University CIO Chris Sedore 估计,校内约有四到五成的人至少每周使用一次 AI,其中一部分跑在学校提供的系统里,另一部分则成了脱离管控的“影子 AI”(going rogue)。
报告总结了三条破局路:设计即治理(Governance by design)、按出错代价做风险分级(Risk tiering),以及 “批准模式,而不是逐个批准用例”(Approve patterns, not individual use cases),并在结尾抛出关键追问:控制到底放在模型外部,还是写在 Prompt 里指望它自觉遵守?
我们的解法
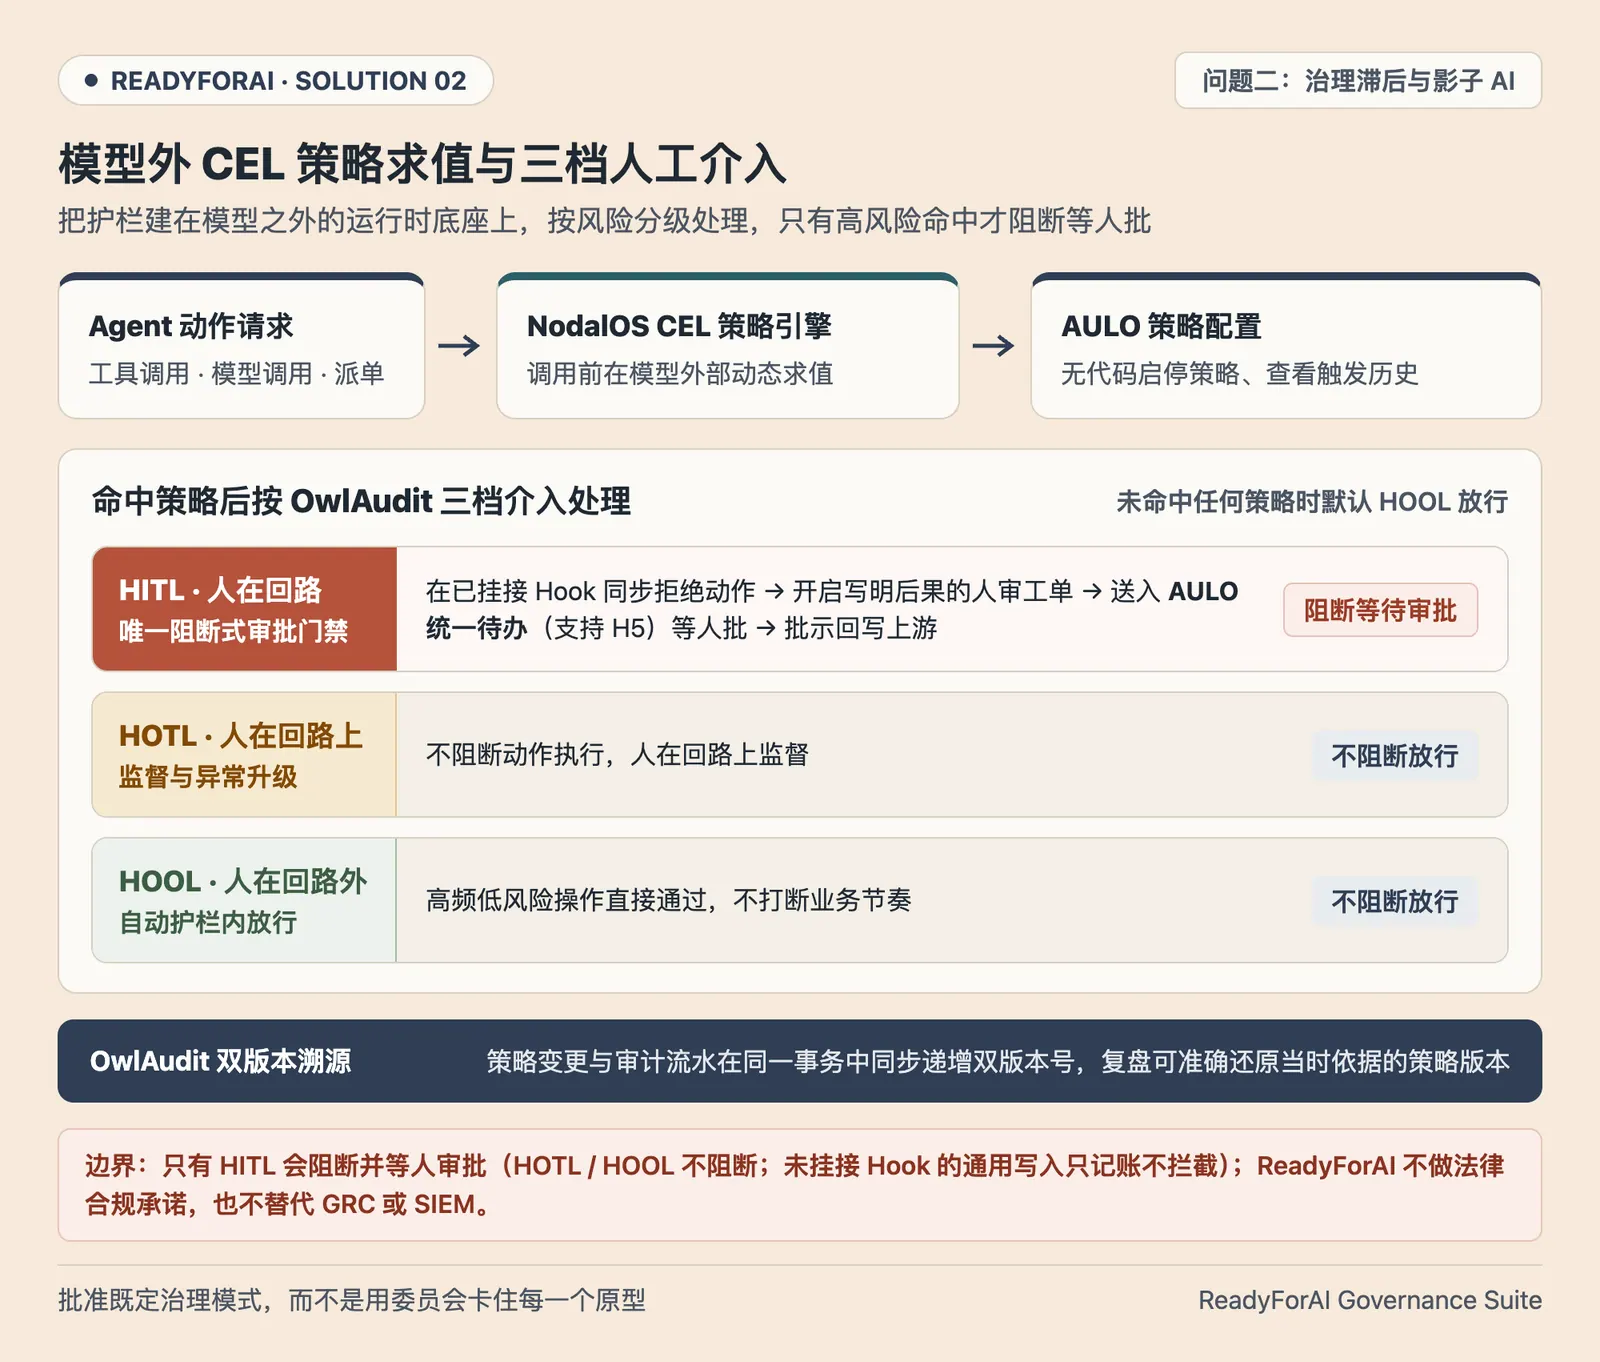
如生产环境不相信 Prompt所述,工程治理不能指望模型自觉遵守提示词,因此我们用 NodalOS、OwlAudit 与 AULO 在模型外部建起分层防线。NodalOS 在工具调用、模型调用和派单前对 CEL 策略动态求值,并在已挂接的 Hook 拦截点对接 OwlAudit 评估合规策略、按三档人工介入处理(HITL / HOTL / HOOL),其中仅 HITL 同步阻断动作并生成写明批准与拒绝后果及超时去向的人审工单,送到 AULO 统一待办(支持移动端 H5)等待批示并回写上游;策略变更与审计流水在同一事务中递增双版本号,管理员在 AULO 即可无代码维护与启停策略。这样高频低风险操作顺畅流转,高风险动作则有阻断门禁与策略版本溯源。
边界
在 OwlAudit 的三档介入中,只有 HITL 会阻断动作并等人审批,HOTL 与 HOOL 不拦截;在未挂接 NodalOS Hook 的路径上,通用写入接口也只记账不阻断。ReadyForAI 提供的是运行时技术工具,不做任何法律合规承诺,也不替代企业法务审查或既有的 GRC / SIEM 平台。
三、成本失控:无基线与账单冻结
问题
报告第 6 章指出,把当年“搬迁上云”的 FinOps 经验直接搬来管 AI 成本走不通。传统上云迁移的是历史基线清晰的既有负载,而 AI 创造的是上季度根本不存在的新工作负载,没有基线可以外推。
同时,单位成本波动极大:摘要一份 5 页合同只要几美分,摘要 200 页就要数美元,质量检查失败触发自动换强模型重试,还会让费用在用户无感知的情况下成倍放大。叠加杰文斯悖论——斯坦福 AI Index 与 Menlo Ventures 数据显示,GPT-3.5 级推理单价两年内降了 280 倍,2025 年企业生成式 AI 总支出反而增至三倍——以及麦肯锡指出的智能体任务中 60% 成本来自检查、修复与复核,支出往往悄然攀升,直到季度审查爆出“账单惊喜”,迫使高管一刀切冻结预算。
报告强调应让开销与预期商业回报挂钩(如 AT&T 将 2000 多个用例绑定预期回报,实现当年 5 倍自由现金流),并在平台侧按项目/Agent 拆分成本、用 Best Buy CIO Neal Sample 所说的“交叉开关(crossbar capabilities)”路由模型,在网关层追踪成本与执行策略。
我们的解法
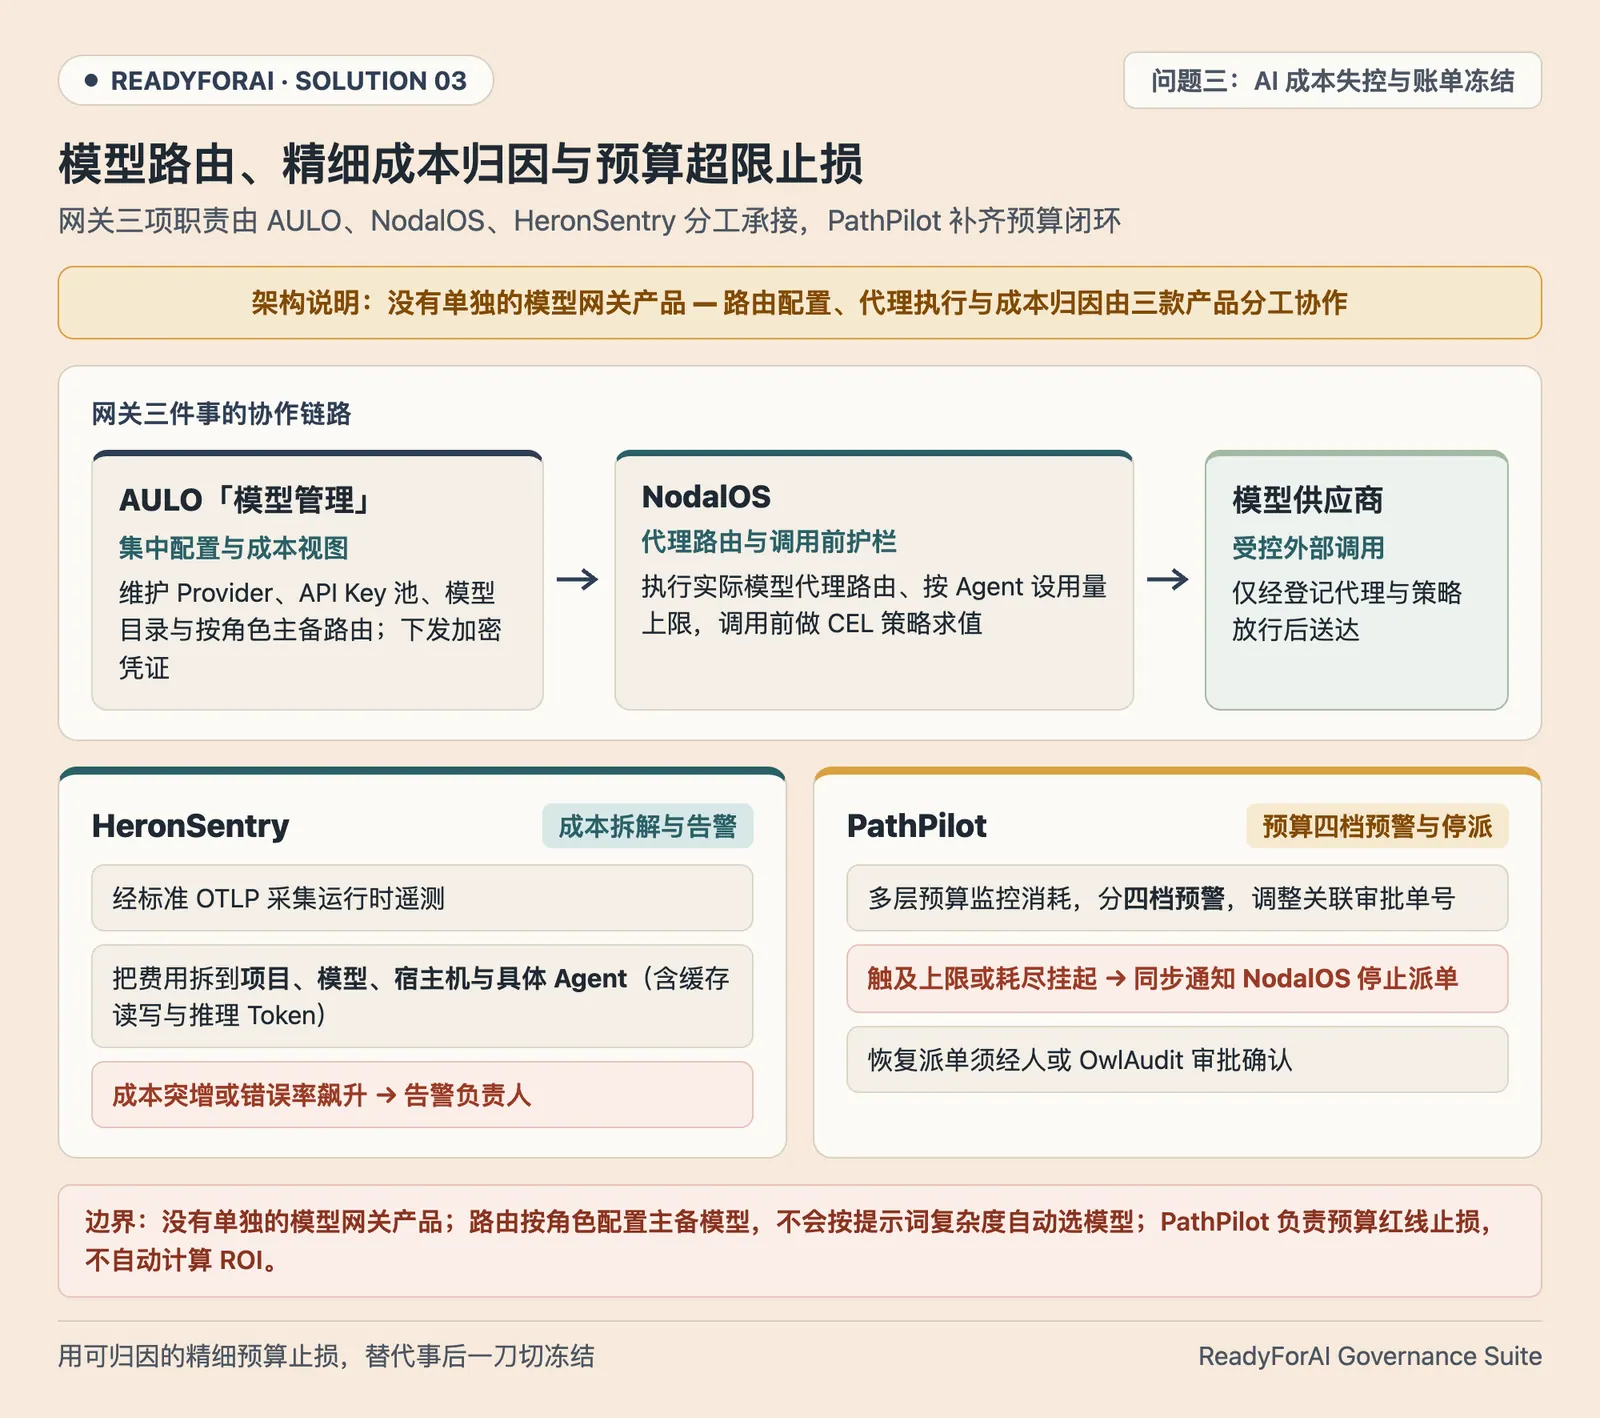
对应报告定义的网关三件事,我们用 AULO、NodalOS、HeronSentry 与 PathPilot 分工承接并补齐预算闭环。AULO 的「模型管理」集中维护密钥池、模型目录、按角色主备路由配置与成本视图,加密凭证下发给 NodalOS;NodalOS 执行实际的模型代理路由、按 Agent 设用量上限并在调用前做 CEL 策略求值;HeronSentry 通过 OTLP 把费用拆到项目、模型、宿主机与具体 Agent 并在突增时告警;PathPilot 提供多层预算四档预警,超限或耗尽挂起时同步通知 NodalOS 停止派单,恢复须经审批确认。企业由此看清各项目与 Agent 的 AI 开销,用逐级止损取代一刀切冻结预算。
边界
ReadyForAI 没有独立的模型网关产品,上述能力由 AULO、NodalOS 与 HeronSentry 组合承担。同时,模型路由是管理面按角色配置的主备路由,不会按提示词复杂度自动选模型;PathPilot 负责预算红线预警与超限停派,不自动计算 ROI,开销值不值仍需业务团队对结果负责。
四、上下文腐烂:散落、歧义与矛盾
问题
报告第 7 章指出,当各家都能用上同样的大模型时,真正拉开结果差距的是企业自己的数据与上下文。企业数据分为两层:结构化、可查询的系统层,以及散落在员工头脑、邮件、聊天记录与流程文档里的人类层 / 组织上下文(institutional context)。
过去人类靠经验默默兜底了大量语义歧义。报告举过一个具体例子:CRM 里某个字段标着“勿联系(do not contact)”,客户经理都知道实际是指“只能通过 CFO 的行政助理联系”,但这句话从未写进系统文档;到了机器速度下,Agent 按字面执行,就会把重要客户直接剔出续约序列。访谈中,几乎没有哪家企业靠横向大项目一次性把“所有数据治理成 AI 就绪”取得过成功,有效团队都是围绕具体用例一边用、一边把隐性语义编码出来。
第 8 章进一步指出上下文层的三道工程难题:建起来只是第一关,第二关是保持新鲜(有企业因过时文档拉低准确率而叫停生产部署),第三关是管理矛盾——文档越积越多必然冲突,Agent 自己无法判断该信哪一份。
我们的解法
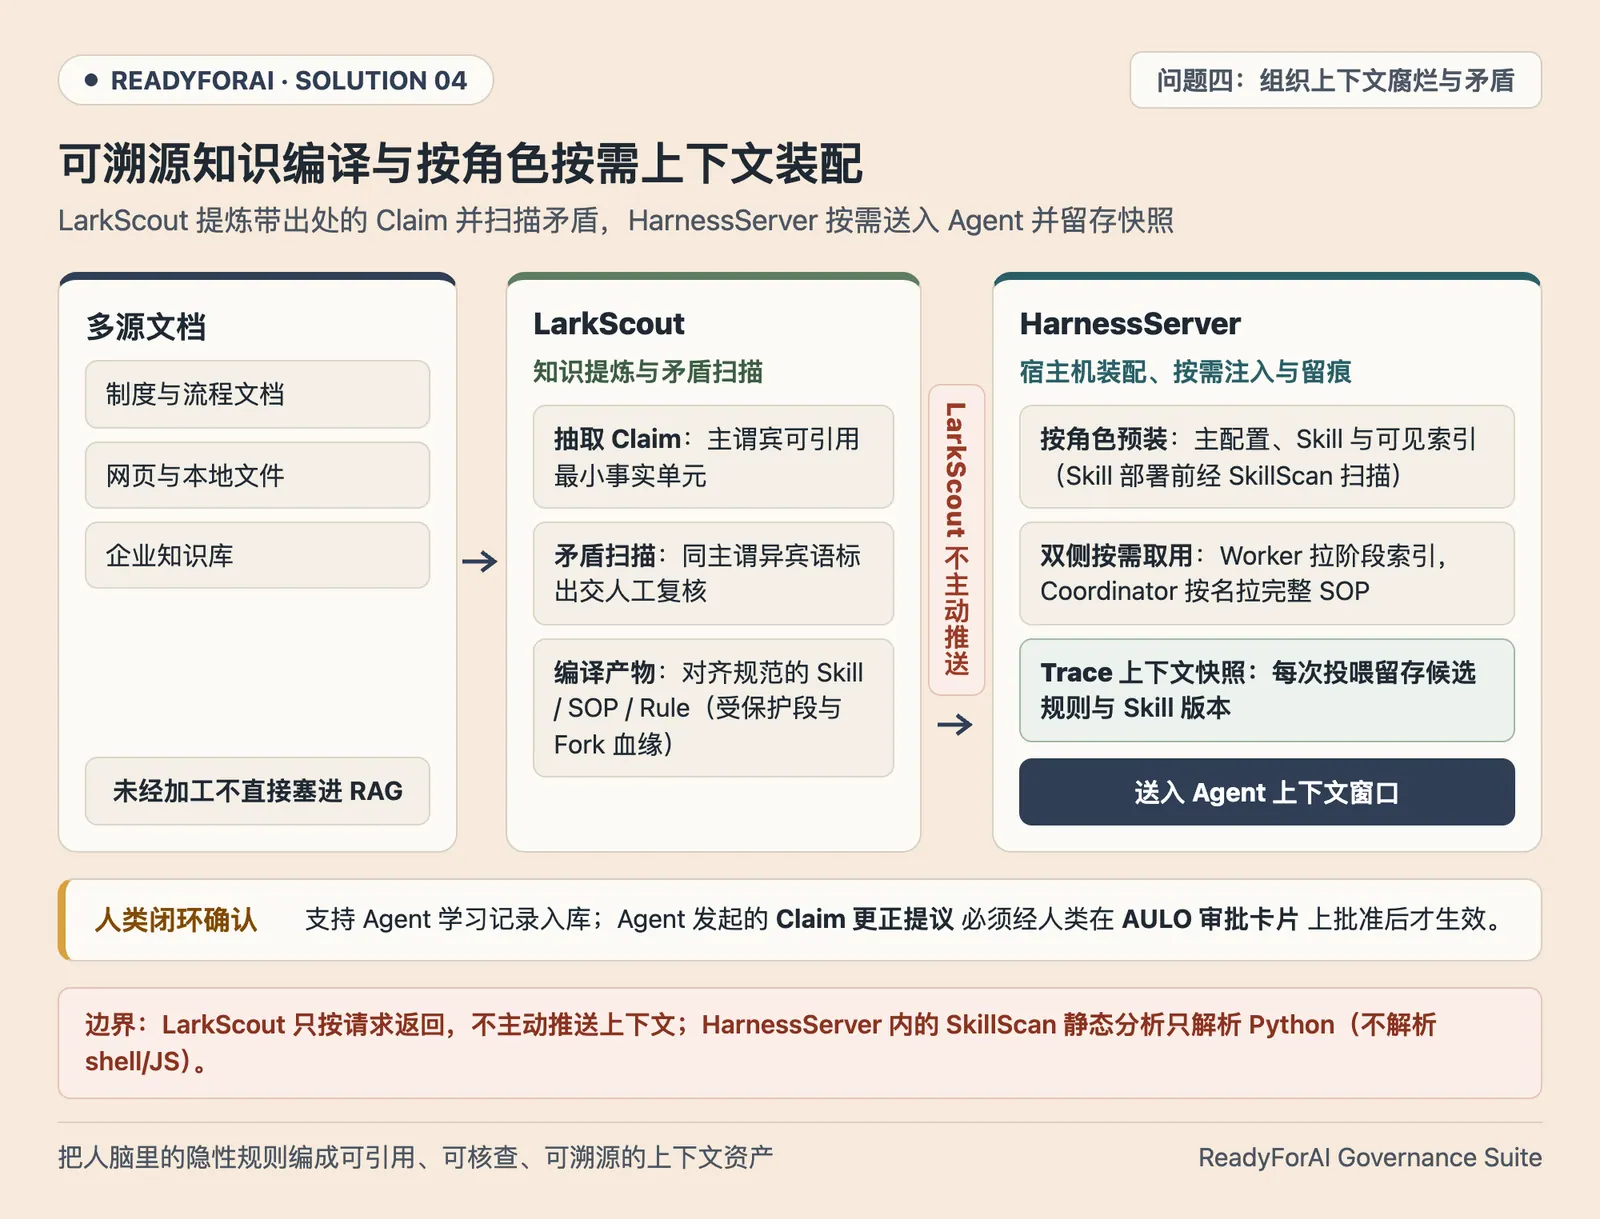
延续写篇流水账就叫 SKILL?的三道硬门思路,我们用 LarkScout 与 HarnessServer 形成上下游配合。LarkScout 不把原始文档直接倒进 RAG,而是从多源文档抽取主谓宾结构化、可引用溯源的 Claim(断言),按“同主谓、不同宾语”自动扫描矛盾交人工复核,并编译成对齐 agentskills.io 的 Skill / SOP / Rule(支持受保护段与 Fork 血缘,Agent 发起的 Claim 更正须人在 AULO 批准后生效);HarnessServer 在宿主机按角色预装配置与索引、支持双侧按需注入并按 Trace ID 留存上下文快照。这既挤掉了无效文档噪音,也让每次任务依据哪版制度有据可查。
边界
LarkScout 只做知识编译与按请求返回,不主动向 Agent 推送或注入上下文,哪些内容进入上下文窗口完全由调用方 HarnessServer 与 NodalOS 决定;HarnessServer 内的 SkillScan 静态扫描只解析 Python,不分析 shell 或 JS,也不替代运行时沙箱与人审。
五、概率系统黑盒:运行监控与越界检验
问题
传统软件建立在“相同输入产生相同输出”的确定性假设之上,昨天通过的测试今天就能签发上线;但 AI Agent 是概率性的,同样的任务跑两次可能走完全不同的工具路径、得出不同结论。正因为如此,报告把评估与可观测基础设施列为赋能平台的四大支柱之一,不仅要在上线前检验,更要在生产中持续监测边界。
Motorola Solutions 副总裁 Jeremiah Nelson 在报告中提出,必须看清正在发生什么、花了多少钱、用了什么工具以及是否存在知识产权风险,才能及时纠正。第 8 章进一步强调了监控完整交易路径(Monitor the transaction path):单步动作孤立来看可能都正常,整条调用链却可能给出错误结果,因此每次模型调用、工具选用和检索内容都必须可回溯并结合异常告警阈值把控风险。在上线前,如 Fortive 会让智能体与现有人工流程并行影子运行,一致性达到 95%、98% 或 99% 且稳定后才放行上线。
我们的解法
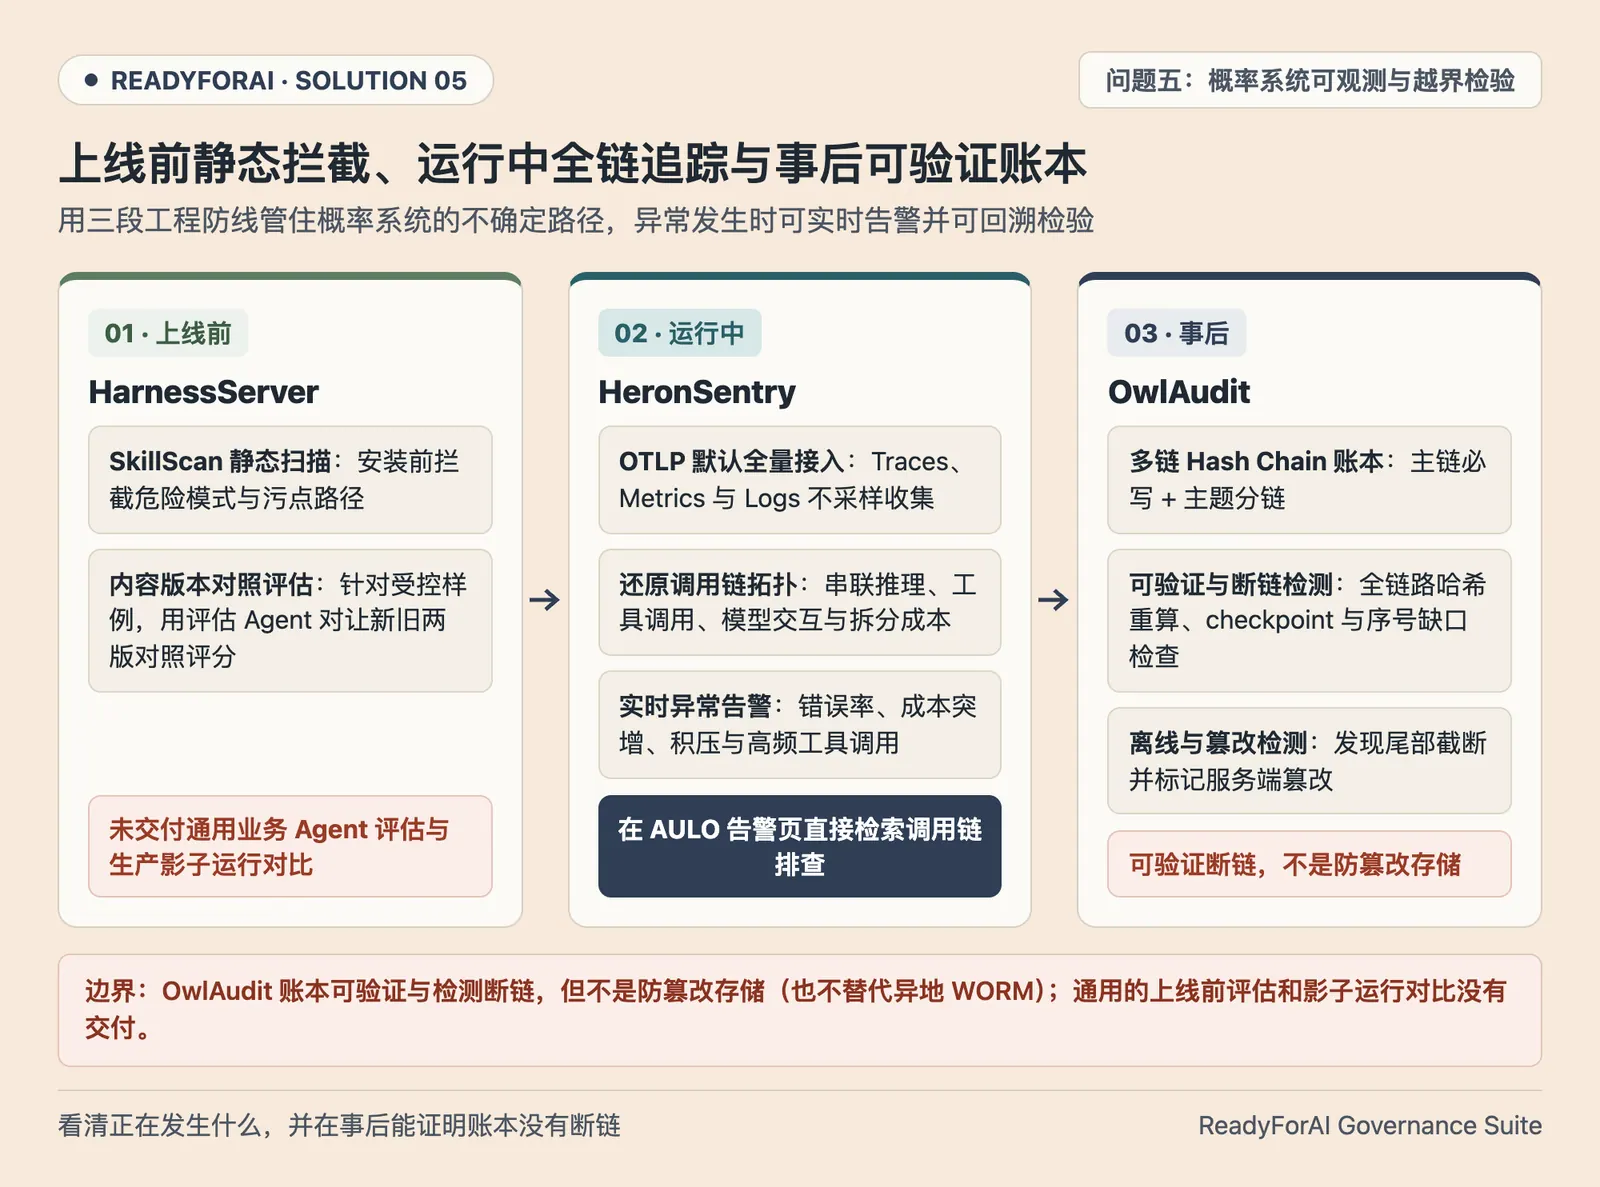
面对概率系统的黑盒焦虑,我们通过 HarnessServer、HeronSentry 与 OwlAudit 建立上线前、运行中与事后三段防线。上线前,HarnessServer 通过 SkillScan 静态扫描拦截危险模式,并对内部内容修订提供受控样例下的新旧版本对照评估;运行中,可独立部署的 HeronSentry 通过标准 OTLP 默认全量接收遥测,还原调用链拓扑、拆分成本并对错误率、成本突增等异常实时告警,值班人员可在 AULO 告警页直接检索排查;事后,OwlAudit 的多链 Hash Chain 账本支持全链路哈希重算、序号缺口检查,并可配合另行保存的链尾做离线尾截断检测。这让纳入观测的调用链在出事时查得清、事后也能校验账本是否连续自洽。
边界
第一,OwlAudit 审计账本可验证与检测断链,但不是防篡改存储,不保证数据源头的物理真实性,也不替代异地 WORM 存储。第二,通用的上线前评估和影子运行对比没有交付,我们不提供 Fortive 式的生产并行影子对比或任意业务 Agent 的全量生产轨迹回放评测,常规回归验证仍需依赖团队自有测试集与灰度发布。
六、集群治理:智能体数量远超人类
问题
报告第 5 章把这一题称为即将全面袭来的下一关:集群治理挑战(The fleet governance challenge)。单看一个 Agent 怎么管,很多团队已经摸出了门道;但当几百、几千个 Agent 同时以机器速度并行运转时,问题的性质就变了:
- 据报告,Amazon 全球商城财务 AI 转型与产品总监 Amber Hanson 提到,她的三人团队已经在支持 300 多个智能体,治理难点从“管人”变成了“管一支机器速度运转的数字劳动力”;
- 在 OLX Group,每个商品列表页背后大约跑着 15 个智能体,全市场同时做决策的智能体超过 4,200 个;
- Citibank 推行了覆盖 90 个国家、18 万名员工的强制开发框架,核心就是建立统一的 Agent 注册清单(inventory)、明确负责人(owner),并配齐可观测、评估与测试能力。
堵住集群治理缺口需要注册表、Agent 间明确的通信与数据边界、集群异常监控,以及端到端的人类问责——每一个动作最终都要能追溯到一位具名的自然人,而不是模糊的委员会。
我们的解法
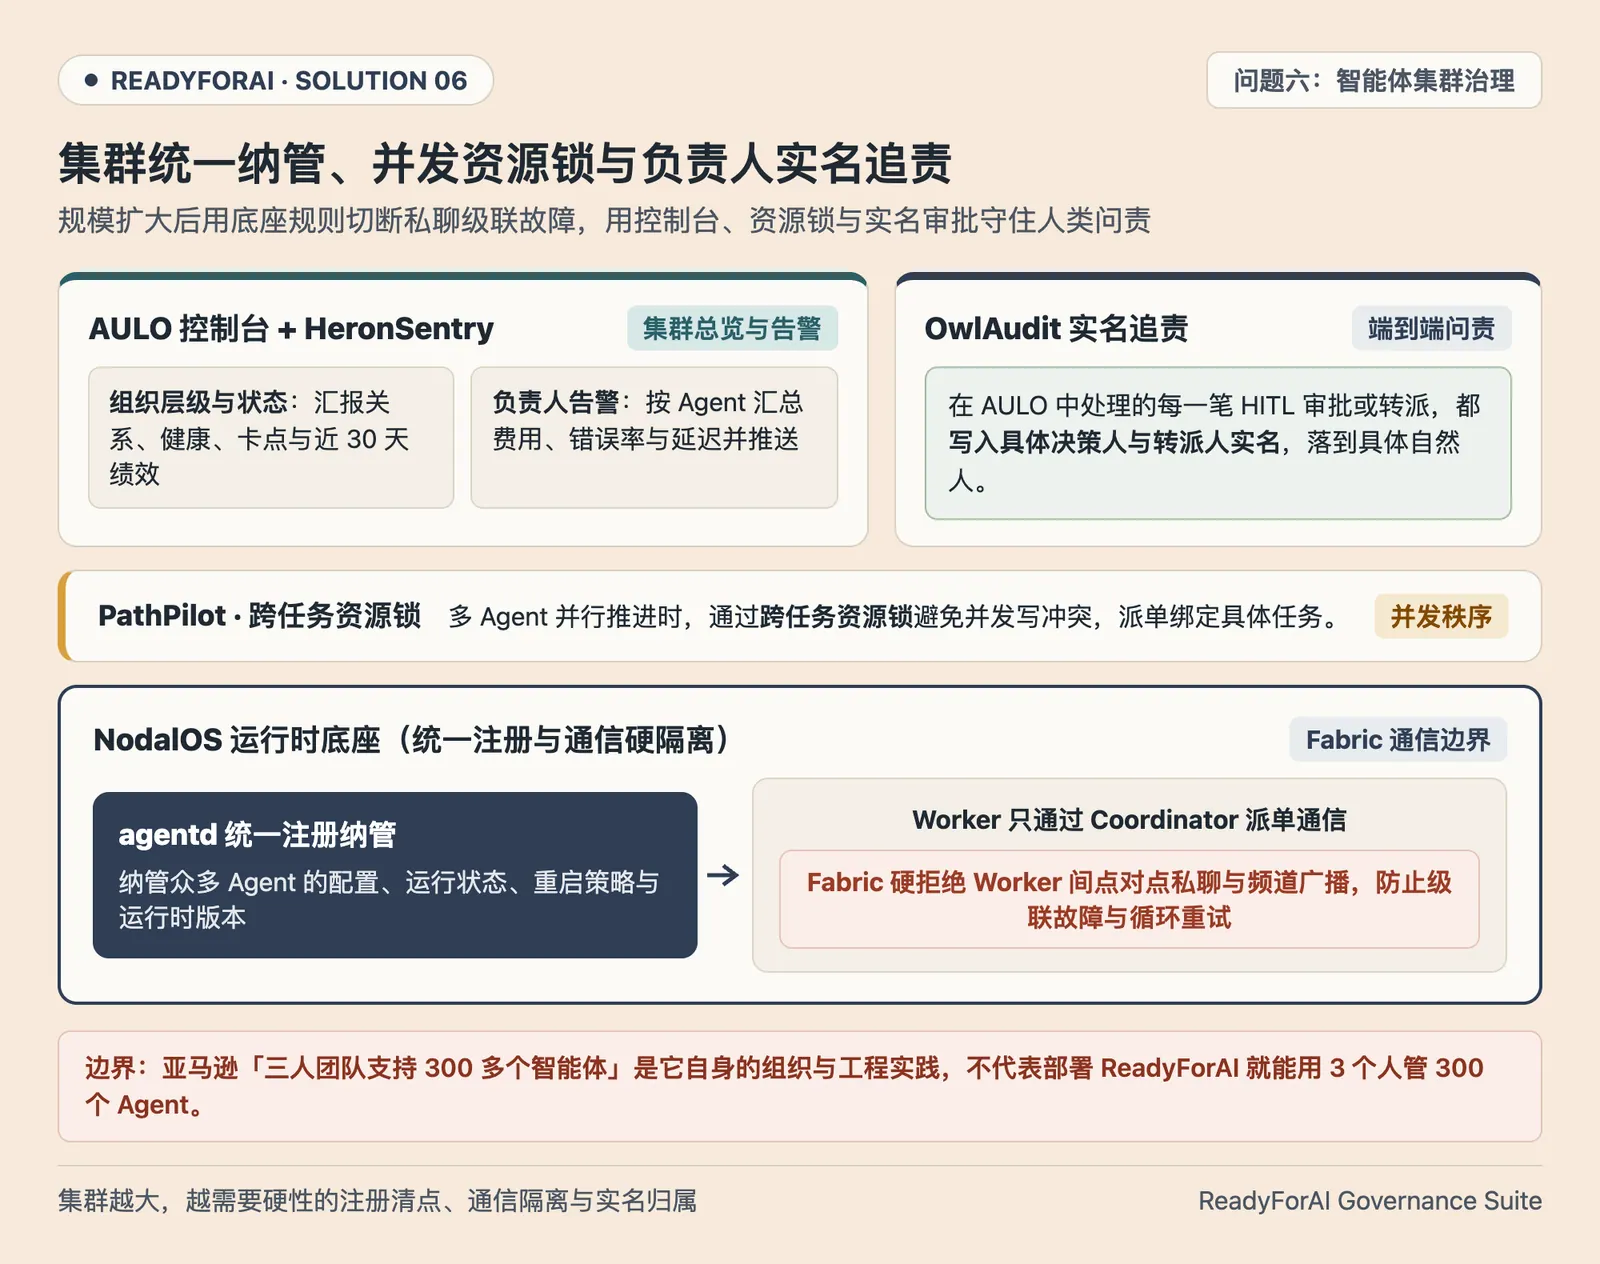
随着集群规模放大,我们用 NodalOS、AULO、HeronSentry、PathPilot 与 OwlAudit 协同守住运行秩序。NodalOS 通过 agentd 统一注册并守护纳管的众多 Agent,同时在 Fabric 总线上硬性禁止 Worker 之间点对点私聊与广播,协作统一经 Coordinator 派单;AULO 控制台与 HeronSentry 一起呈现 Agent 组织层级、健康状态与资源消耗,并将异常告警推给负责人;多 Agent 并行推进时,PathPilot 用跨任务资源锁防止并发写冲突,OwlAudit 则在 AULO 处理或转派审批工单时写明决策人或转派人。这样既从机制上切断了群聊级联故障,也让每笔审批决策责任到人。
边界
报告里亚马逊“三人团队支持 300 多个智能体”,是它自身的组织与工程实践,并不意味着部署 ReadyForAI 套件就能用 3 个人管 300 个 Agent。ReadyForAI 解决的是统一注册、通信隔离、并发资源锁与实名审计秩序,具体人机管理配比仍取决于业务风险与运营投入。
七、决策边界:谁来拍板、什么必须人批
问题
报告第 10 章直面了一个很少在技术白皮书里被点破的事实:概率系统带来的个人问责焦虑。领导者很清楚,一旦 AI 出现幻觉、泄密或合规事故,最终站出来担责的依然是具体的自然人(“I’ll be the one accountable”);同时各类老软件纷纷贴上“Agentic”标签,CIO 被迫充当“首席怀疑论者(Chief Skeptic)”。
更大的管理难题出在决策权边界(decision rights)上:当团队一天就能做出新功能,糟糕的判断比好的判断传播得更快。领导者既不能事无巨细亲自审批(否则会重演“守门人瓶颈”),也不能把判断权直接让渡给概率系统,必须建立清晰规则——区分哪些边界内可快速试错,哪些高后果选择必须经多视角碰撞(哈佛教授 Linda Hill 所说的建设性摩擦 creative abrasion)与人为终裁,并为项目定下明确的止损标准(kill criteria)——据报告,Crypto.com 的 Jason Lau 的原则是:没有负责人、没有指标、没有通往结果的路径,项目就必须砍掉。
我们的解法
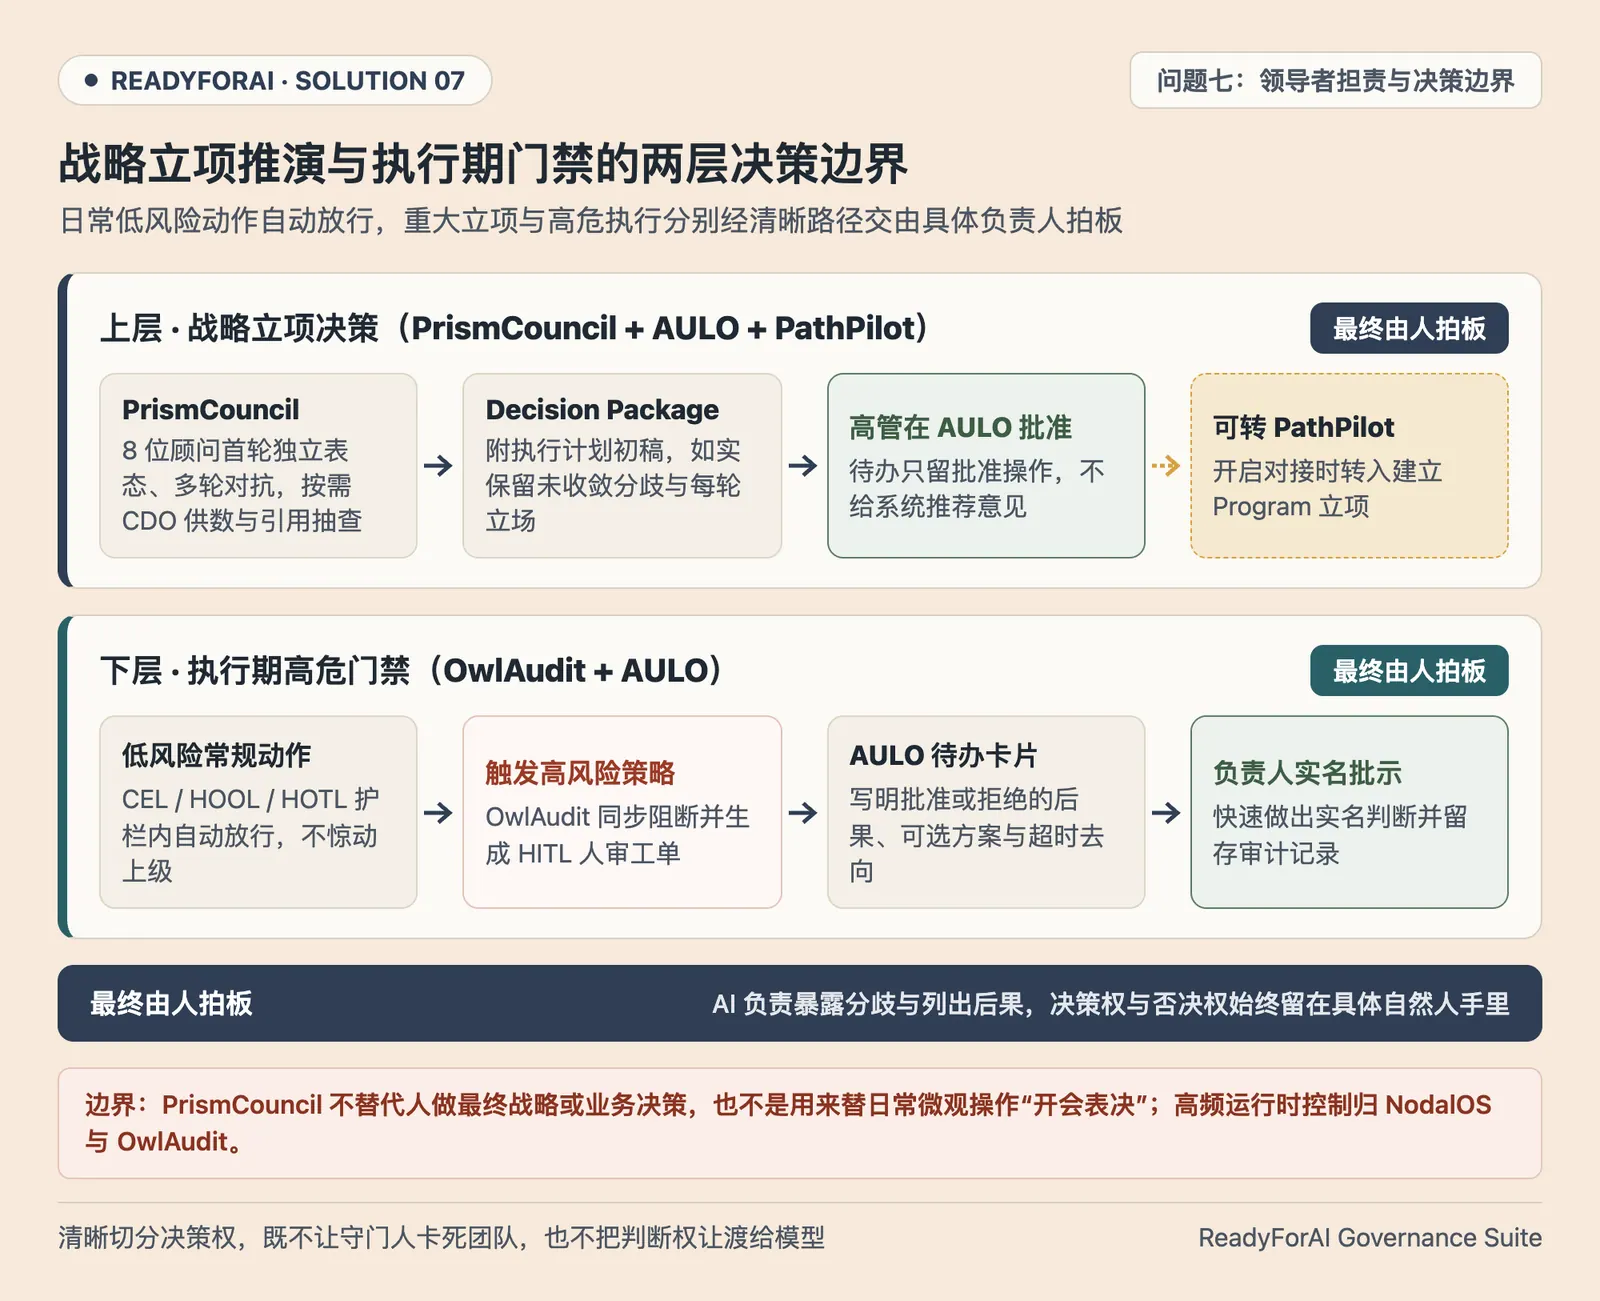
延续从 Shopify CEO 的 AI 幕僚团谈起的产品路径,我们用 PrismCouncil、OwlAudit 与 AULO 把决策边界切分为战略与执行两层。面向“要不要做、投多少”的重大议题,PrismCouncil 按议题调度内置顾问(共 8 位)首轮独立平行表态、展开多轮对抗并按需由 CDO 供数,产出保留未收敛分歧的 Decision Package,交由高管在 AULO 审批(开启 PathPilot 对接时可转为 Program 立项);面向执行期微观看门,常规低风险操作在自动护栏内放行,命中 HITL 策略的高危动作由 OwlAudit 生成写明批准与拒绝后果及超时去向的工单送入 AULO 待办,由负责人实名批示。两层最终都由人拍板,既不让审批卡死日常研发,也守住关键人类判断权。
边界
PrismCouncil 不替代人做最终战略或业务决策(待办卡片甚至刻意只保留批准操作而不给系统推荐意见,否决或结案只能由高管本人决定),也不用于给日常每次微观调用“开会表决”;高频低延时运行时控制依然属于 NodalOS 与 OwlAudit 的职责范围。
结尾:从第一天起,就按上线生产的标准去起步
报告在结尾章节 How to start 提醒所有管理者:行动与等待的代价不对称——马上做小范围试错,就算失败也只损失几周时间;原地观望等待,损失的是数月的协同。
在结尾给出的「下周一就能做的五件事」(Do this Monday)以及全章原则里,有两条特别值得工程团队记住:
- 按 Oxy CTO Patrick Bangert 的话:“从第一天就把项目当成完整上线项目来起步(start projects as full deployment projects)”:探索可以小步快跑,但监控、成本归因、合规护栏和生产负责人从第一天就得在位,避免做出一堆永远进不了生产的“派对魔术与科学小实验”。
- 启动前先写清楚“谁来担责”与“止损标准(kill criteria)”:如果一个项目连谁在生产环境接手都找不到志愿者,或者没有明确指标与通往业务结果的路径,就果断停掉。
把这几件事落回工程底座上,其实并不神秘:用 NodalOS 和 PathPilot 管住异构运行时与任务预算边界,用 HeronSentry 与 OwlAudit 从第一天接上全链路可观测、HITL 门禁和可验证审计账本,用 LarkScout 与 HarnessServer 持续沉淀干净、可溯源的组织上下文,再通过 AULO 与 PrismCouncil 把日常审批与重大立项的最终拍板权交还给具体的人。
如果你的团队正在评估如何把现有的 AI 试点稳妥推进到生产环境,可以先从AI 治理诊断梳理当前的运行时、审计与成本盲区,或者直接联系我们讨论具体架构落地路径。
参考资料
- AWS Executives in Residence. Reimagine: Turning AI into Value. 2026. 官方页面:AWS Executive Insights — Reimagine
- Werner, J. (2026). Agentic AI: Bridging the Widening Gap Between Ambition and Execution. AWS Executive in Residence Blog. 原文链接
- Gartner Inc. (2025-06-25). Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. 原文链接