LarkScout
LarkScout 是面向 AI Agent 的企业级知识平台——在多源采集、文档解析、文档预览之上,做断言(Claim)抽取、 知识视图编译、矛盾扫描与经验回流,把企业知识编译成 Agent 能消费、Claim 可溯源的知识资产,避免将未经加工的海量文档直接注入 RAG 导致噪音与幻觉。


LarkScout
Knowledge & Skill Compilation面向 Agent 的企业级知识平台给 Agent 的不是一堆搜索命中,是编译好的、可溯源的知识。
- 编译
- 给的是知识,不是搜索命中
- 可溯源
- Claim 级引用
- 闭环
- 矛盾扫描 + 人工确认回流
- Skill
- 对齐 agentskills.io
典型痛点
- RAG 召回低质量,上下文窗口被噪音填满
- 经验沉淀不下来,Agent 反复犯同类错误
- 知识更新后 Agent 还在用旧版本
核心价值
Skill、SOP 与规则的统一目录
LarkScout 编译好的 Skill、SOP 与规则集中列在 AULO 内容库里,每条带版本、发布者、可见性和适用的 Agent 分类。
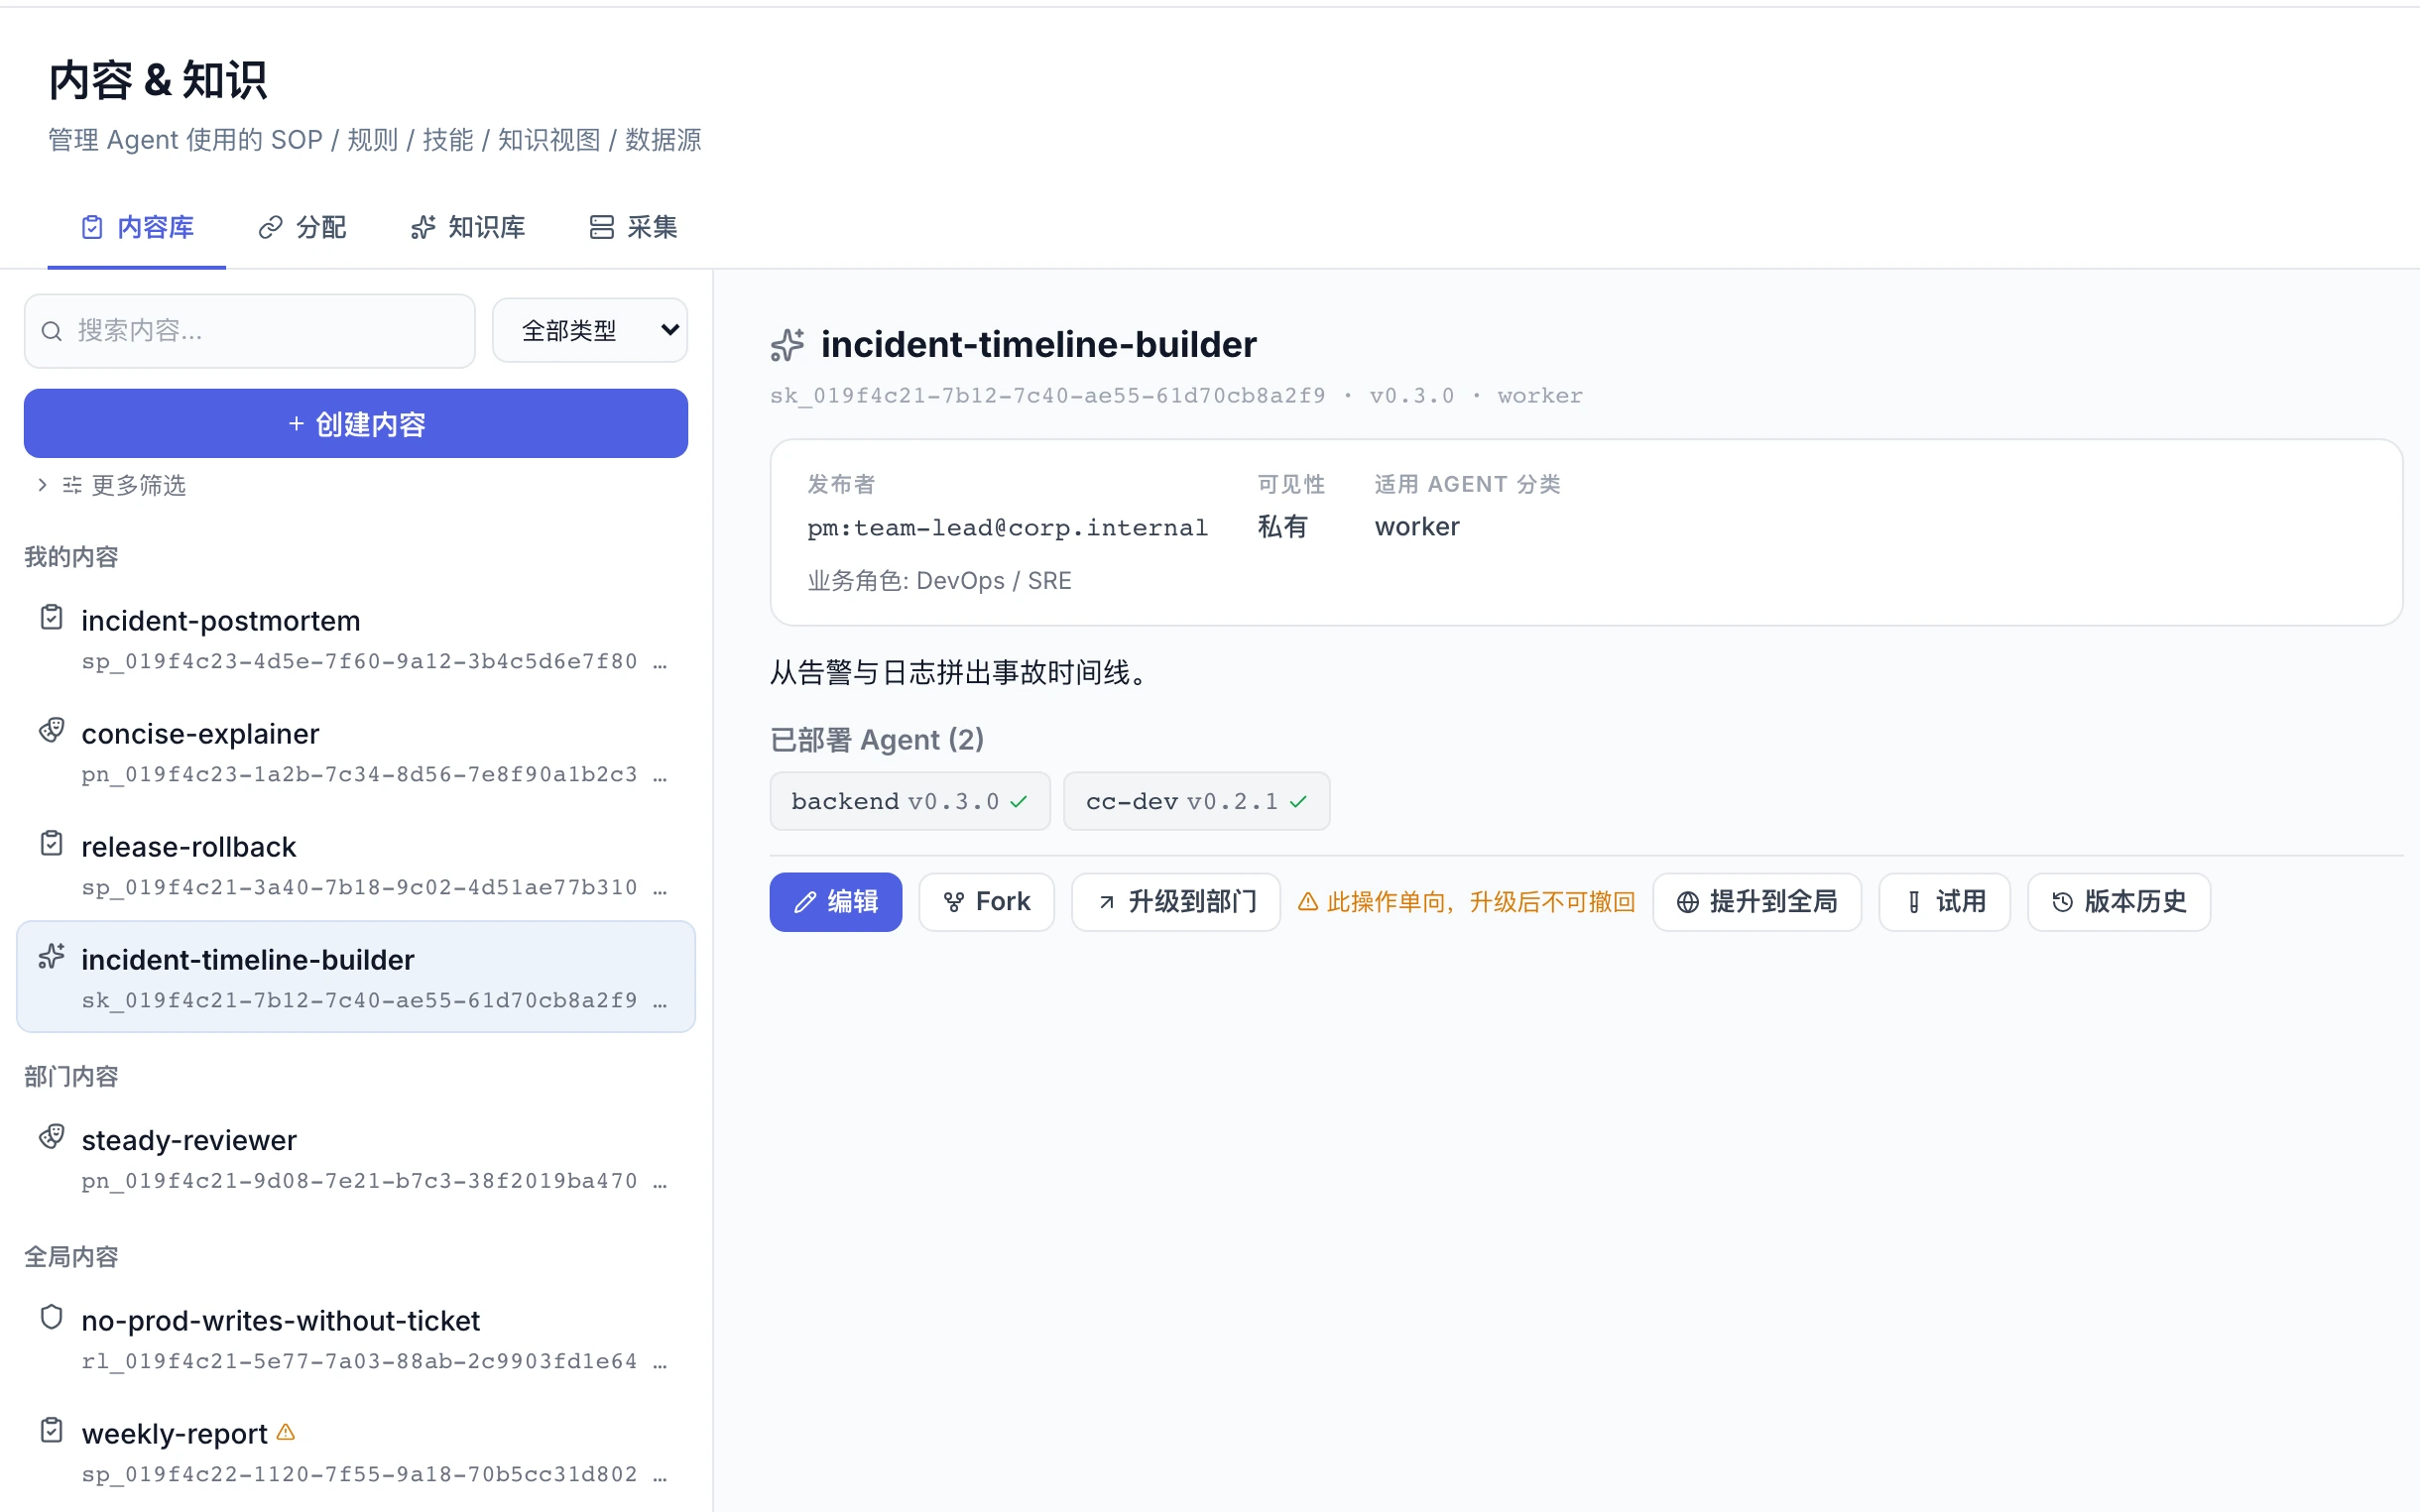
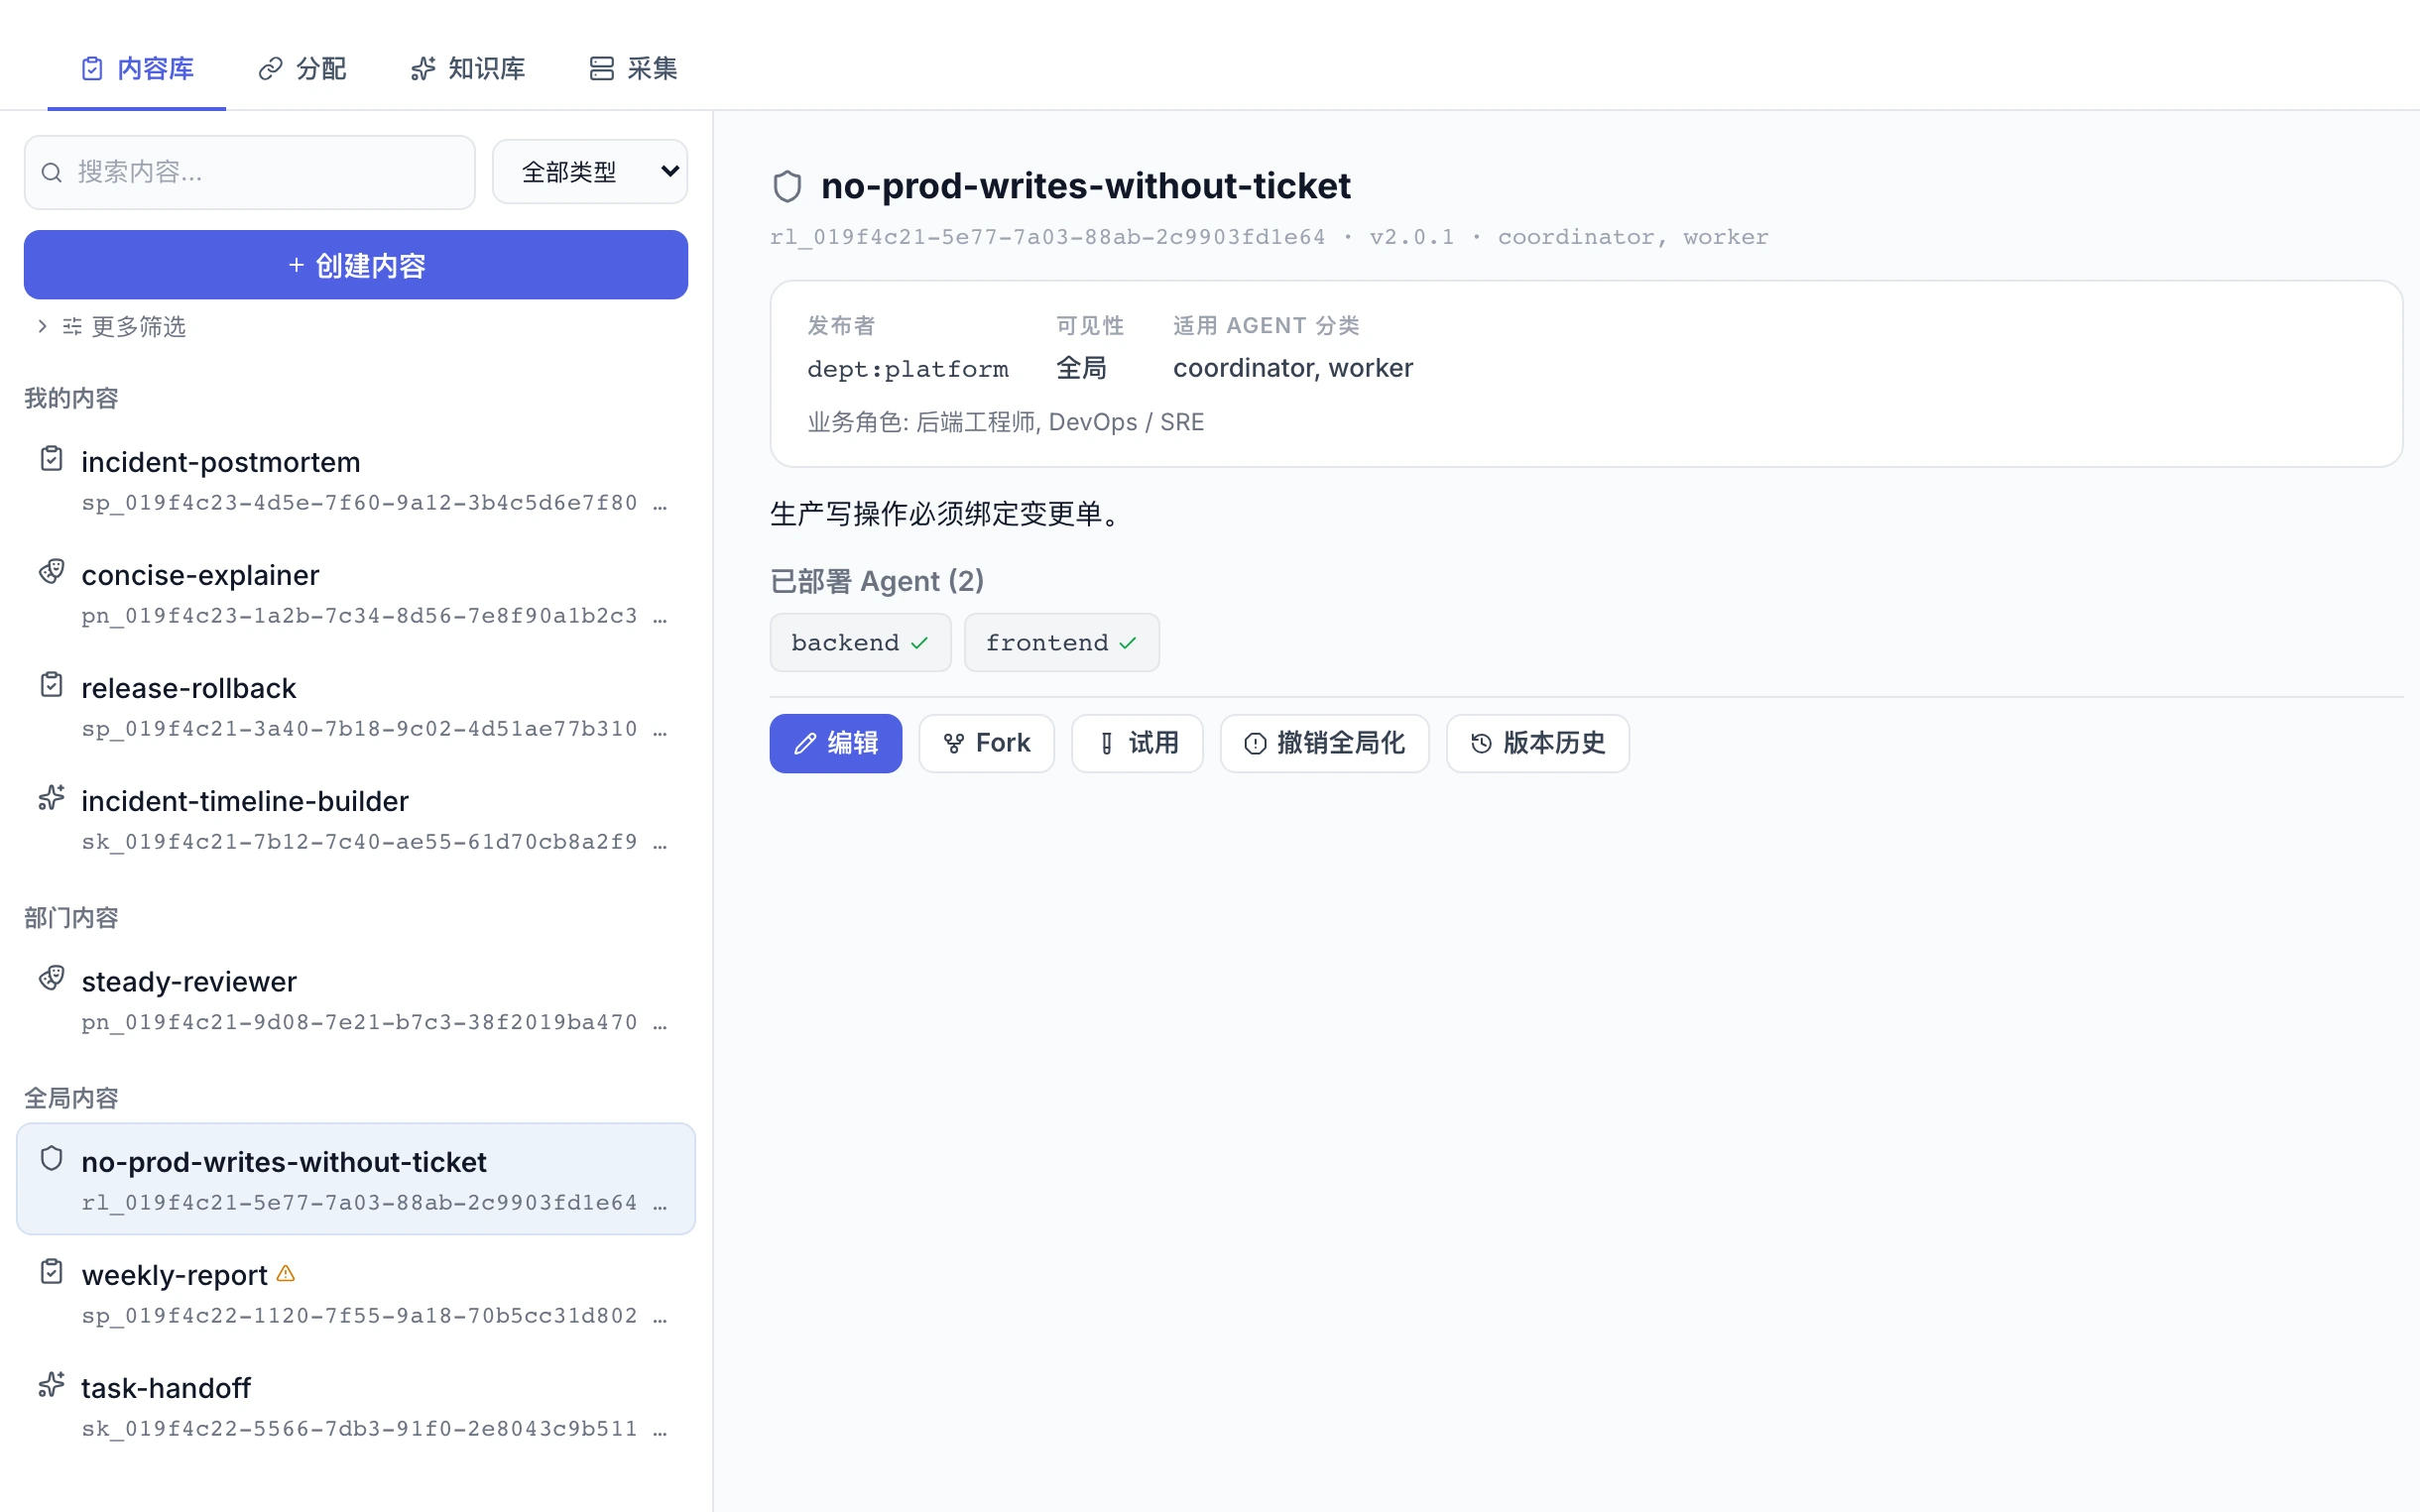
SOP、规则、SKILL 与 Persona 分层归属
内容库把 SOP、规则、SKILL 与 Persona 按归属(我的/部门/全局)分层收纳,已部署到哪些 Agent 与版本一目了然。
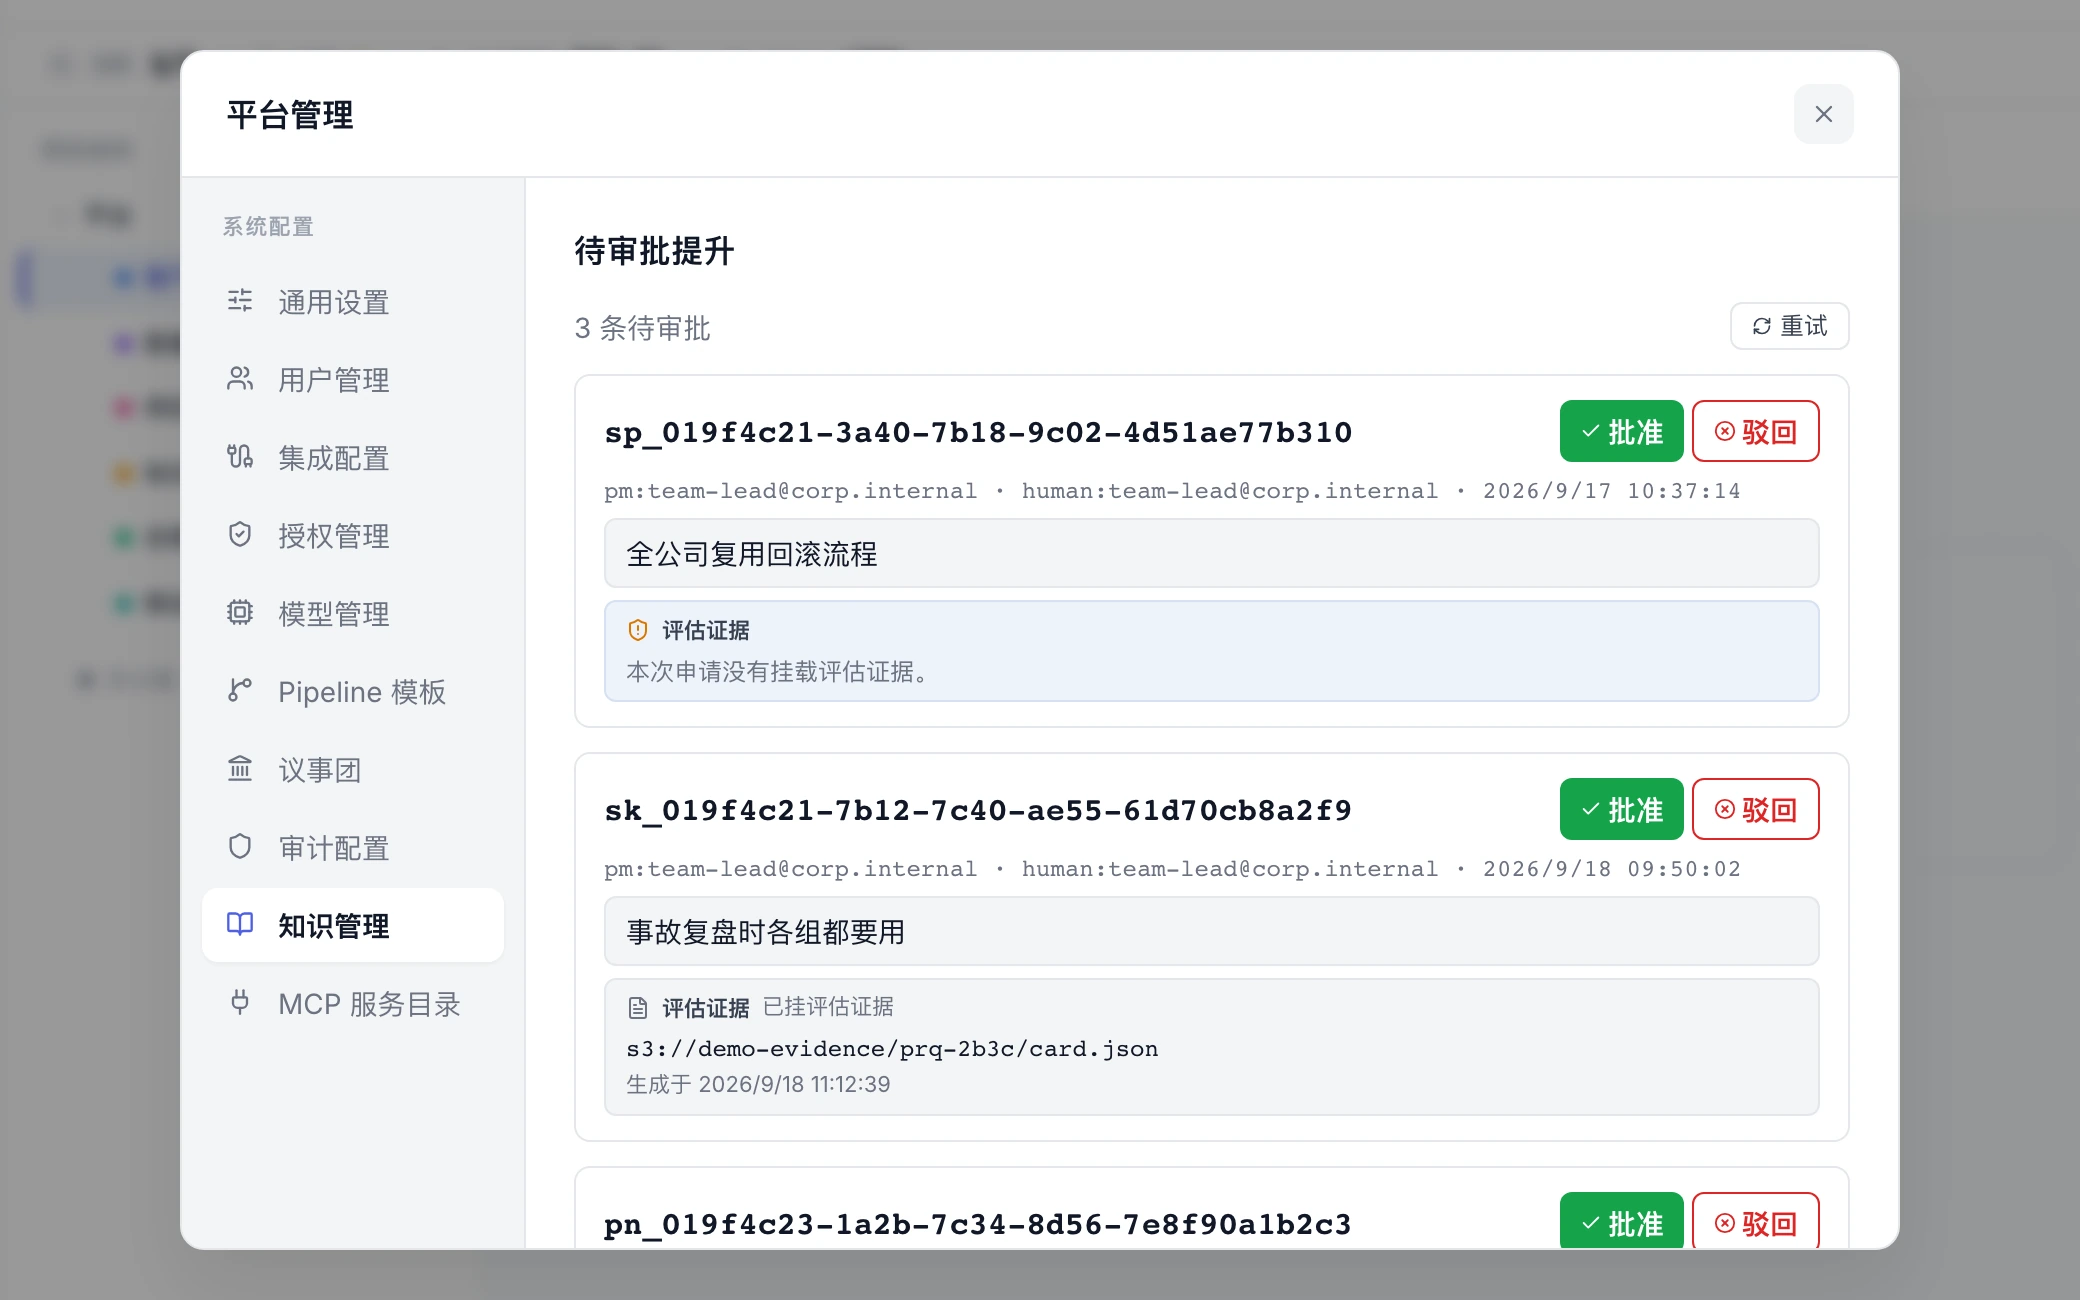
内容提升审批与证据留痕
内容从个人向部门或全局层级提升时需经审批,申请理由与运行证据留痕逐条可查。
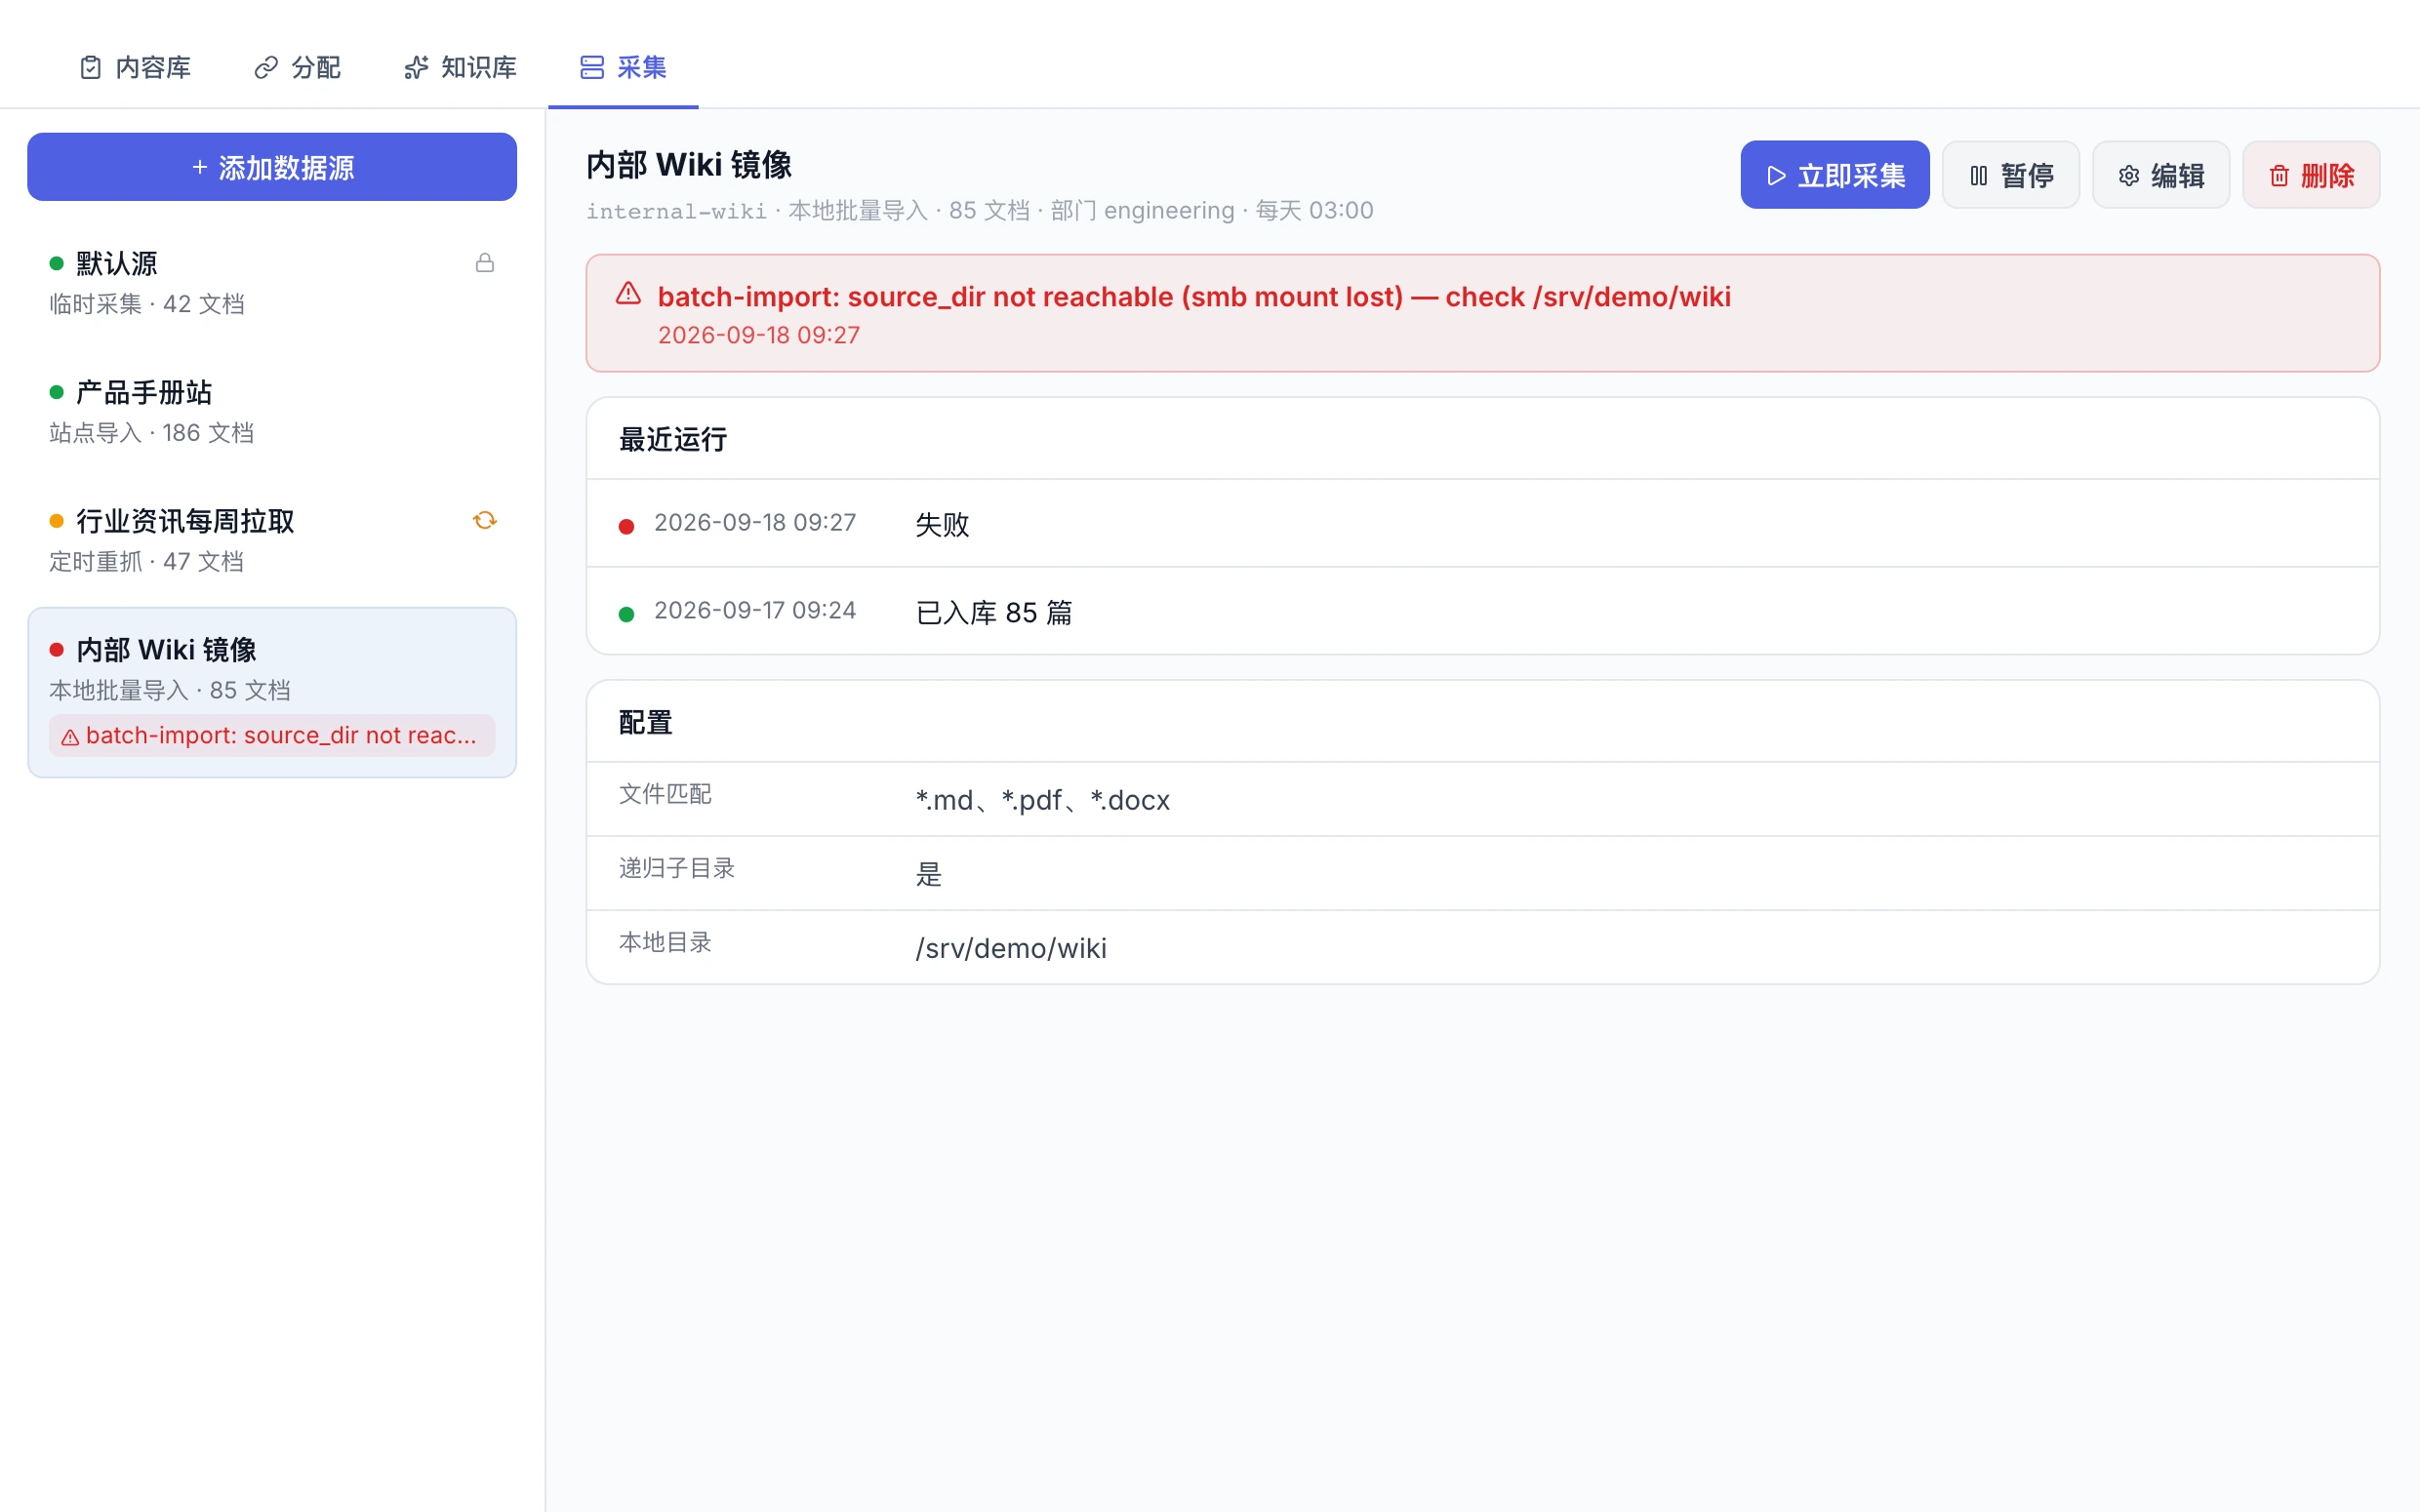
多源定时抓取与运行追溯
支持站点抓取、批量导入与定时接入等多种模式,各数据源的抓取进度、产出篇数及失败原因清晰呈现。
核心能力
知识提炼
数据接入
Agent 内容编译
安全与血缘
能做 / 不做
能做
- 结构化 Claim 抽取与知识视图编译:将文档提炼为可引用的最小事实单元
- 知识矛盾扫描与经验回流:自动识别冲突知识,支持 Agent 经验学习与人工确认
- 多源企业文档解析与站点策展:支持主流文档格式与语雀/微盘/飞书接入
- Agent 内容标准化编译:编译 Skill / SOP / Rule,原生兼容 agentskills.io 规范
- SKILL Bundle 批量导入与三层安全门:格式校验、解压防护与 YARA 进程隔离扫描
- 受保护段声明与官方 MCP 知识检索:支持 Fork 血缘追踪与 mTLS 鉴权接入
不做
- 不替代企业既有 Wiki 或内容管理系统(定位于面向 Agent 消费的知识编译加工层)
- 不直接分发/挂载至 Agent 运行时工作区(编译完成后交由 HarnessServer 按角色下发)
- 不直接向 RAG 注入未提炼的原始粗糙文本(只输出结构化 Claim 与可溯源知识视图)
按角色看
技术负责人
知识结构化为可引用 Claim 与视图,而不是将未经提炼的文档直接注入 RAG
合规与风控
知识源可追溯;MCP 可开启,经 mTLS 与 NodalOS 受控接入,不是公网无鉴权端点
业务负责人
经验经人工确认后再复用,新 Agent 上线不必从零摸索
集成与依赖
NodalOS 运行时与 mTLSHarnessServer 内容同步与下发AULO 知识面板与预览PrismCouncil 独立交付时自管议事 SKILL,不经本服务注册